SEM 结构方程模型
在测量模型基础上分析潜变量结构路径。
1. 方法概述
(1)结构方程模型(Structural Equation Modeling,SEM)把测量模型和结构模型放在同一框架中,同时分析潜变量如何由观测题项测量,以及潜变量之间的结构路径如何关联。
(2)SEM 适用于有明确理论模型的研究,例如“服务质量通过满意度与使用意愿相关”。它可以估计直接效应、间接效应和总效应,但模型结果仍依赖研究设计、测量质量、模型识别和理论设定。
2. 适用问题与不适用问题
适用情形:
- 有明确的潜变量测量模型和结构路径假设;
- 每个潜变量有多个观测指标;
- 样本量和数据质量能够支持模型估计;
- 研究问题需要同时处理测量误差和多个路径。
不适用或需要谨慎:
- 只有一两个观测变量且不存在潜变量或路径理论;
- 只是想探索题项维度:先做 EFA;
- 数据为明显的分类变量却使用不匹配的连续正态估计;
- 样本量不足、模型过于复杂、参数无法识别;
- 仅凭横断面数据把路径图解释为确定的因果链。
3. 数据结构和模型语法
数据按每行一个观测、每列一个题项或观测变量整理。SEM 必须同时包含测量部分(=~)和结构部分(~),例如:
服务质量 =~ Q1 + Q2 + Q3
满意度 =~ Q4 + Q5 + Q6
使用意愿 =~ Q7 + Q8 + Q9
满意度 ~ 服务质量
使用意愿 ~ 服务质量 + 满意度
要点:
=~表示测量关系(潜变量由题项测量);~表示结构路径,方向是“被预测”:满意度 ~ 服务质量表示服务质量预测满意度;- 至少要有一条潜变量之间的
~结构路径;只有=~测量模型不构成完整 SEM; - 语法中的观测列名必须与数据列名完全一致;潜变量名称是模型里的名字,不是数据列;
- 上传编码表后系统可自动生成测量语法(每个维度至少 3 个题项才会自动生成),但结构路径需要你按研究假设补全(系统不会自动添加未经确认的结构路径)。
4. 分析流程
5. 测量模型和结构模型
测量模型为:
其中 \boldsymbol{\xi} 和 \boldsymbol{\eta} 分别表示外生和内生潜变量。
结构模型可以写为:
其中 \mathbf{B} 表示内生潜变量之间的路径,\boldsymbol{\Gamma} 表示外生潜变量对内生潜变量的路径。
例如,若 X 影响 M,而 M 影响 Y,可以写成:
6. 直接效应、间接效应和总效应
在简单中介结构中,直接效应为 c',间接效应为:
总效应为:
更复杂的路径模型可以将多条路径的乘积相加得到间接效应。间接效应通常使用 Bootstrap 置信区间,因为乘积项的抽样分布往往偏离正态。
7. 拟合、识别和估计
模型需要有足够的信息和约束才能识别。常见识别措施包括固定一个因子载荷、固定因子方差、指定外生变量协方差以及明确误差结构。
整体拟合通常报告卡方、自由度、RMSEA、CFI、TLI、SRMR,以及在比较模型时使用的 AIC/BIC。拟合指标只能表示模型与当前协方差结构的相容程度,不能证明理论唯一正确。
估计方法应根据连续或分类题项、正态性、缺失机制和样本量选择。Likert 题项不能不加判断地当作连续正态变量;如果题项类别较少或分布偏斜,应使用适合有序分类数据的估计方法。
8. 结果表格和图形的阅读方法
系统输出的工作表(analysis_tables.xlsx):SEM拟合指标、SEM拟合评价、SEM参数估计、SEM载荷评价、SEM效度分析、SEM区分效度、SEM分析提示、信度分析、信度题项分析、描述性统计、变量编码表、维度得分、相关矩阵、相关显著性、显著性标记、缺失值报告、频数统计。
示例(来自系统结果包,示例数据)。
SEM拟合指标表:
| 指标 | 数值 |
|---|---|
| chi2 | 61.675774 |
| DoF | 52 |
| CFI | 0.9846 |
| RMSEA | 0.030578 |
| NFI | 0.911167 |
SEM参数估计表:
| 关系 | 非标准化估计值 | SE | z | p |
|---|---|---|---|---|
| =~ | 1.023182991005447 | 0.1299439839799519 | 7.874031253061366 | <0.001 |
| =~ | 0.9509124311271292 | 0.1308042209950832 | 7.269738116194837 | <0.001 |
| =~ | 0.9903018586239883 | 0.1337632552776713 | 7.403392333479615 | <0.001 |
建议输出:
- 模型图或路径关系表;
- 整体拟合指标;
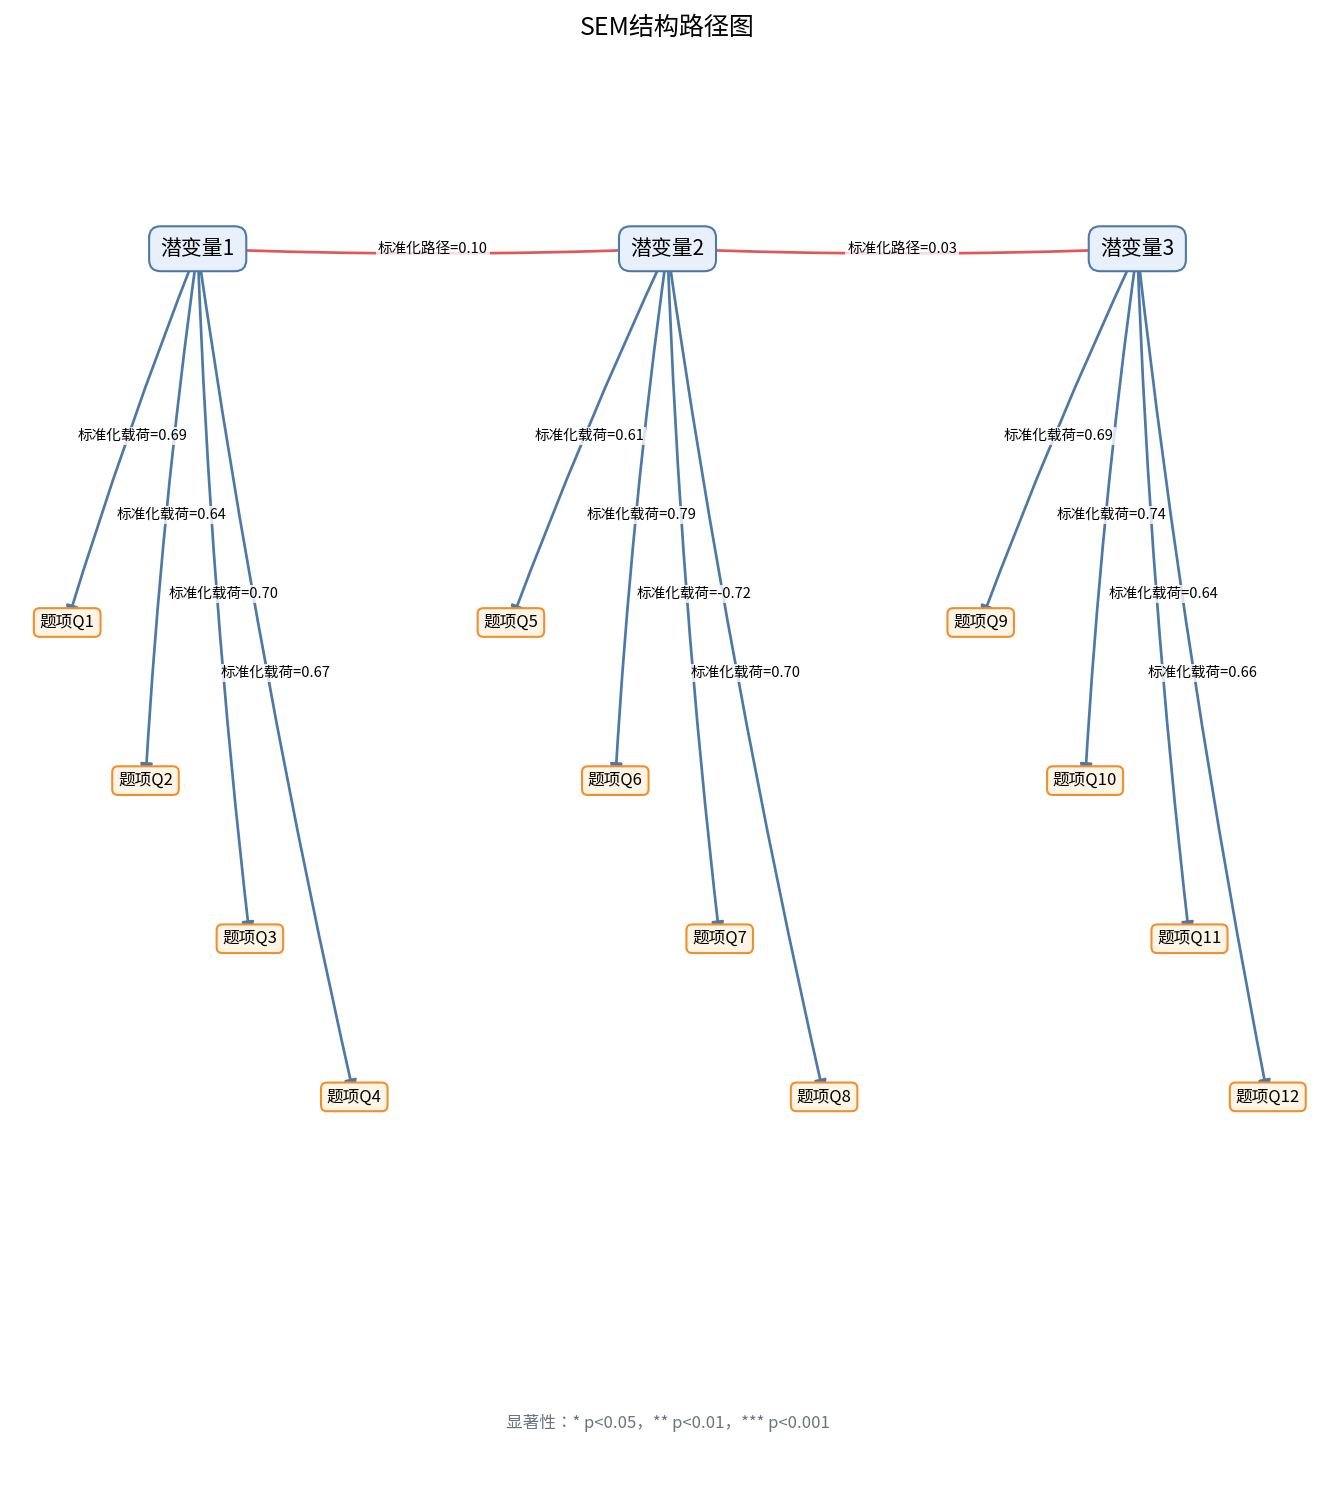
- 标准化因子载荷和测量误差;
- 结构路径系数、标准误、p 值和置信区间;
- 直接效应、间接效应和总效应;
- 必要的模型比较和稳健性分析。
模型图用于展示结构,表格用于精确报告。解释路径方向时应明确变量编码、参考组和标准化方式。
9. 结果表述边界
可以表述为:“结构方程模型中,服务质量对满意度的标准化路径系数为……,满意度对使用意愿的路径系数为……;服务质量通过满意度产生的间接效应为……,Bootstrap 置信区间为……。”
若研究是横断面观察数据,应使用“与……相关”“与……路径相符”等谨慎表述,不应仅凭 SEM 路径图写成确定因果关系。
10. 常见问题
- 先画路径图再寻找显著关系:模型应由理论和研究问题驱动。
- 测量模型没有通过仍解释结构路径:应先确认题项能够合理测量潜变量。
- 只看拟合指标不看载荷和路径方向:整体拟合与局部参数都需要检查。
- 用修正指数无限加路径:可能造成过拟合和结果不可复现。