信度分析
Cronbach α 与 CITC,判断量表题项的内部一致性。
1. 方法概述
(1)信度分析用于判断一组题项是否具有相对稳定的内部一致性。常用指标是 Cronbach's α,也可以结合校正后题项-总分相关(CITC)以及删除某个题项后的 α 一起判断题项质量。
(2)它回答的是:同一个量表维度中的题项,是否在一定程度上测量了相近的内容?
(3)信度不是效度,也不是因果分析。α 较高只能说明题项之间具有较强的内部一致性,不能单独证明量表一定是单维结构、一定有效、一定适合预测,或研究假设已经成立。
(4)信度分析通常是问卷和量表分析的基础步骤。它可以在相关、差异检验、回归、EFA、CFA、SEM、中介或调节分析之前使用,但必须先确认题项确实属于同一理论维度,并且有足够的有效数据。
2. 适用问题与不适用问题
适用问题
信度分析适合:
- 多道李克特题项组成一个量表维度。
- 同一个概念由多个题项共同测量。
- 在相关、回归、EFA、CFA 或 SEM 前检查题项一致性。
- 比较不同维度的内部一致性。
- 发现某道题与同维度其他题项方向不一致。
- 检查删除某道题后 α 是否明显变化。
例如:
- 服务质量由 Q1、Q2、Q3、Q4 测量。
- 满意度由 S1、S2、S3 测量。
- 使用意愿由 W1、W2、W3 测量。
不适用问题
以下变量不应直接放在同一个量表中计算 α:
- 性别、地区、专业、年级等人口统计变量。
- 用户编号、订单编号、时间戳等 ID 或元数据。
- 本来就不是同一个概念的多个变量。
- 只有一道题的单题指标。
- 纯类别名称或开放文本。
- 题项方向没有统一且反向题没有处理。
- 样本量过小或所有被试的回答完全相同。
把性别、年龄、满意度和购买金额放在一起计算 α,即使得到一个数,也没有清晰的量表解释。应在分析前根据理论和编码表排除控制变量与分类变量。
3. 数据结构和输入要求
数据文件
数据可以整理为 CSV 或 XLSX。每一行是一份问卷或一个观测对象,每一列是一道题项或一个变量。
示例:
| 编号 | Q1 | Q2 | Q3 | Q4 | 性别 |
|---|---|---|---|---|---|
| 1 | 4 | 5 | 4 | 2 | 1 |
| 2 | 3 | 4 | 3 | 3 | 2 |
| 3 | 5 | 5 | 4 | 1 | 1 |
如果 Q4 是反向题,不能直接将它与 Q1-Q3 计算 α,应先按量表范围反向计分。
编码表
建议同时准备编码表。平台下载的编码表模板使用以下中文表头(英文表头同样可识别):
| 表头 | 作用 | 示例 |
|---|---|---|
| 变量 | 数据中的列名 | Q1 |
| 题项名称 | 题项说明 | 服务响应及时 |
| 维度 | 所属维度 | 服务质量 |
| 类型 | 变量类型或角色 | 数值 |
| 反向题 | 是否反向题 | 否(或 1/0、是/否) |
| 最小值 | 量表最小值 | 1 |
| 最大值 | 量表最大值 | 5 |
- 编码表中的“变量”应与数据列名一致;“维度”相同的数值题项才会归入同一维度。
- “反向题”支持 1/0、是/否;标为反向题的题项会先反向计分再计算 α。
- “类型”一般量表题项填“数值”;控制变量、分类变量、编号等可填
control/categorical/id,系统会把这类列排除在量表题项之外。
题项数和样本要求
常见的计算前提是:
- Cronbach α 至少需要 2 个题项。
- 每个维度少于 2 个题项时,该维度无法计算 α。
- CITC 和删除题项后的 α 最好在每个维度至少有 3 个题项时使用。
- 题项诊断需要有足够的完整有效数据。
- 完整案例少于 2 行时,α 无法计算。
- 总分方差为 0 时,α 无法计算。
至少 2 个题项只是计算的下限,不代表量表设计充分。题项数量、内容覆盖和理论维度需要由研究者判断。
会进入量表分析的变量
以下变量通常不应作为量表题项:
- 控制变量、分类变量和分组变量;
- 性别、地区、专业、年级等人口统计变量;
- 用户编号、订单编号、时间戳等识别变量;
- 不属于该理论构念的其他指标。
数字编码的分类列不能因为保存为 1、2、3 就被当成量表题项。
4. 分析流程
信度分析不应只凭一个指标自动删除题项。最终是否删除题项需要结合题意、理论结构、EFA/CFA 结果和研究设计。
5. 反向题处理
为什么需要反向计分
同一维度中,如果大多数题目是“分数越高表示程度越高”,而某道题含义相反,就要把反向题转换到同一方向。
例如:
- 正向题:我认为系统操作方便。
- 反向题:我认为系统操作复杂。
如果都使用 1-5 分而不处理反向题,操作方便得分高的人可能在操作复杂题上得分低,题项相关方向会被拉低。
反向计分公式
设原始题项值为 X,量表最小值为 L,最大值为 U,则:
五点量表为:
对应关系:
| 原始值 | 反向值 |
|---|---|
| 1 | 5 |
| 2 | 4 |
| 3 | 3 |
| 4 | 2 |
| 5 | 1 |
量表范围的确定
- 优先使用量表设计规定的理论最小值和最大值。
- 五点量表通常为 1 至 5,七点量表通常为 1 至 7。
- 如果量表范围不明确,应先查阅问卷说明,不能只根据当前样本的最小值和最大值推断。
如果样本没有出现理论最低分或最高分,建议在编码表中填写理论范围。例如五点量表应填 1 和 5,而不是只依赖当前样本观察到的 2 和 4。
反向题结果
反向计分后应在分析记录中清楚区分原始值和处理后的值。例如:
Q4 -> Q4_R
整理结果时应区分原始题项和反向计分后的题项,避免同一题被重复计入。
6. Cronbach's α 完整公式
设量表包含 k 个题项,有 n 个完整案例。第 i 个样本在第 j 个题项上的得分为 Xᵢⱼ。
题项总分
第 i 个样本的总分为:
通常使用题项总分计算总分方差。使用题项平均分会改变尺度,但不改变题项之间一致性关系的基本含义。
题项均值和方差
第 j 个题项的均值:
第 j 个题项的样本方差:
样本方差的分母为 n-1。
总分均值和方差
总分均值:
总分样本方差:
Cronbach's α
Cronbach's α 为:
其中:
- k:题项数量。
- sⱼ²:第 j 个题项的样本方差。
- sT²:题项总分的样本方差。
- 题项和总分使用同一批完整案例。
题项之间的共同变异越大,通常 α 越高;方向相反、测量内容差异很大或随机误差较多时,α 可能降低。
平均题间相关形式
若所有题项已经标准化,平均题间相关为 r̄,则:
平均题间相关为:
式(6.7)可用于理解题项数量和平均题间相关对 α 的影响。实际报告时应说明采用的计算口径。
7. 缺失值与完整案例
完整案例处理
某个维度包含 k 个题项时,完整案例集合为:
有效完整案例数为:
一种清晰且常用的处理方式是对该维度使用完整案例计算,即该样本在该维度的所有题项都有有效值时才纳入 α 计算。它不同于对每一对题项分别使用不同样本的成对删除方法。
完整案例处理的影响
优点:
- 所有题项方差和总分方差使用同一批样本。
- 结果口径清楚,容易复核。
- 题项之间的样本口径一致。
影响:
- 一行中只要有一道题缺失,该行就会从该维度 α 计算中排除。
- 缺失较多时,有效样本量可能明显下降。
- 不能直接把当前 α 和使用均值填补、成对删除或多重插补的数据结果比较。
维度得分和 α 的口径不同
计算维度得分时,可以使用该行已有题项的平均分,但应明确最低有效题项数。维度平均分可写为:
其中 Oᵢ 是第 i 个样本的有效题项集合,kᵢ 是该样本实际可用的题项数。
因此:
- 维度得分允许部分题项存在时计算。
- α 使用该维度的完整案例。
- 维度得分的有效行数与 α 的有效行数可能不同。
- 后续模型使用维度得分时,应同时查看缺失值报告。
8. 校正后题项-总分相关(CITC)
定义
去掉第 j 个题项后的其余题项总分为:
CITC 为当前题项与其余题项总分的 Pearson 相关:
不能把当前题项与包含自身的总分做相关,因为这会机械性提高相关。
使用条件
题项诊断通常需要满足:
- 维度至少有 3 个题项;
- 题项为可比较的数值编码;
- 有足够的完整数据;
- 删除当前题项后仍有至少两个题项。
因此,2 个题项的维度可以计算 α,但不会产生当前的 CITC 明细表。
CITC 的参考解释
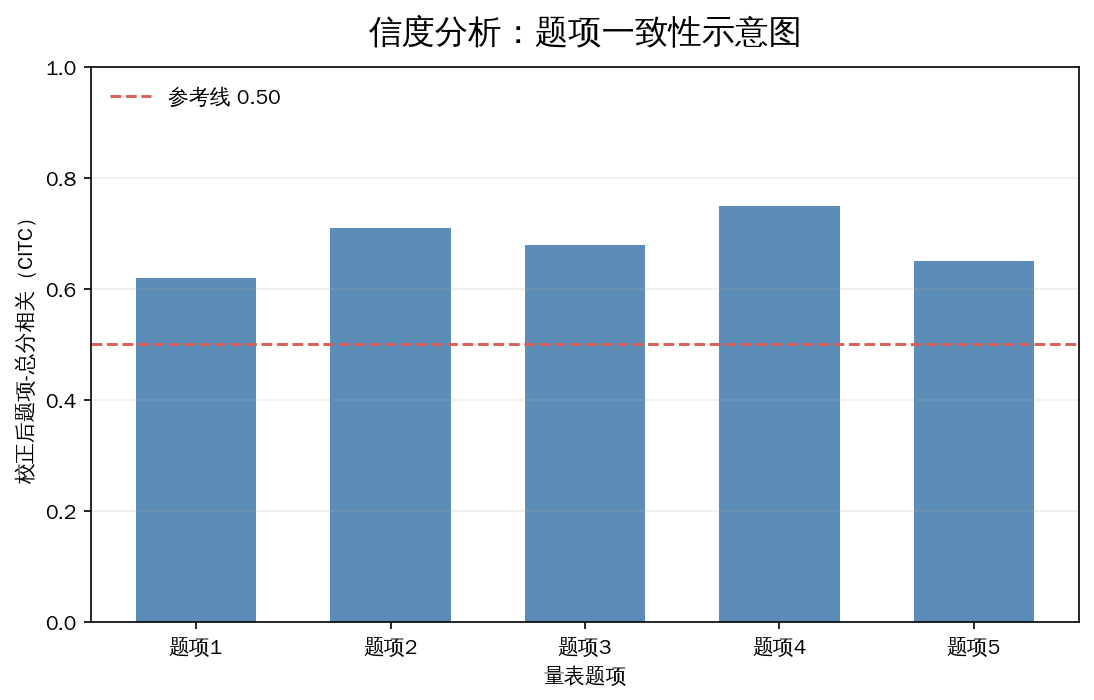
0.30 常被用作初步参考线:
- CITC 较高:题项与同维度其余题项方向和内容较一致。
- CITC 接近 0:题项可能与其他题项关系较弱。
- CITC 为负:优先检查反向计分、数据编码和维度归类。
CITC 小于 0.30 或删除题项后的 α 明显上升时,可以把该题列为复核对象。但 0.30 只是常用参考线,不是自动删除规则。
9. 删除题项后的 α
完整公式
删除第 j 个题项后,剩余题项数为:
剩余题项总分:
剩余题项方差之和:
删除第 j 个题项后的 α:
其中 Var(T·,-j) 是剩余题项总分的样本方差。
如何阅读
将整体 α 和删除该题项后的 α 对照:
- 删除某题后的 α 明显高于整体 α,该题可能降低一致性。
- 删除后变化很小,删除未必有实际意义。
- 删除后 α 下降,该题可能对维度一致性有贡献。
- CITC 为负且删除后 α 明显上升,应先检查反向题和编码,不要立即删除。
不能只追求更高 α
删除题项可能导致:
- 量表内容覆盖变窄。
- 重要内容被删除。
- 理论维度定义改变。
- 题项数量过少,结果不稳定。
- 题项内容重复但 α 虚高。
删除前应同时查看题意、反向题、缺失、CITC、删除后 α、EFA/CFA 和理论定义。
10. α 的解释参考
常见的工作参考如下:
| α 范围 | 常见的初步理解 |
|---|---|
| α ≥ 0.80 | 内部一致性较好 |
| 0.70 ≤ α < 0.80 | 达到常用可接受水平 |
| 0.60 ≤ α < 0.70 | 一致性一般,探索性研究可结合其他证据判断 |
| α < 0.60 | 一致性偏弱,应检查题项和数据 |
这些是常用工作参考,不是任何学科都必须服从的硬标准。还要考虑题项数量、探索性研究性质、内容相似程度、样本量和理论结构。
α 为负时,常见原因是:
- 题项方向相反。
- 反向题没有处理。
- 题项并不属于同一维度。
- 编码错误。
- 样本量很小或数据变异异常。
负 α 应优先排查数据和题项方向。
11. 结果表格和图形
系统输出的工作表(analysis_tables.xlsx):信度分析、信度题项分析、描述性统计、变量编码表、维度得分、相关矩阵、相关显著性、显著性标记、缺失值报告、频数统计。
示例(来自系统结果包,示例数据)。
信度题项分析表:
| 维度 | 变量名 | 均值 | 标准差 | CITC | 删除后α |
|---|---|---|---|---|---|
| dim1 | Q1 | 3.41 | 0.839897 | 0.573455 | 0.707033 |
| dim1 | Q2 | 3.43 | 0.798931 | 0.543793 | 0.722499 |
| dim1 | Q3 | 3.47 | 0.775958 | 0.579874 | 0.704278 |
信度分析表
主要内容包括:
| 字段 | 含义 |
|---|---|
| 维度 | 量表或理论维度名称 |
| Cronbach α | 该维度或总量表的 α |
| 题项数 | 纳入计算的题项数量 |
如果题项不足、完整案例不足或总分没有变异,α 可能无法计算。空值不等于 α 为 0。
题项诊断表
满足条件时通常包含:
| 字段 | 含义 |
|---|---|
| 维度 | 题项所属维度 |
| 变量 | 题项变量名 |
| 均值 | 该题项完整数据中的均值 |
| 标准差 | 该题项完整数据中的样本标准差 |
| CITC | 校正后题项-总分相关 |
| 删除该题项后的 α | 删除当前题项重新计算的 α |
| 提示 | 需要进一步复核的原因 |
完整数值应以结果表为准,简要说明用于快速阅读。
相关的辅助结果
信度分析通常还应结合:
- 描述性统计。
- 缺失值报告。
- 变量编码表。
- 维度得分。
- 相关矩阵。
- 相关显著性。
- 显著性标记。
这些表帮助解释题项和维度,但不能替代信度结果。
简要结果说明
简要结果说明可以包含描述性统计、信度分析和必要的相关结果,例如:
本研究采用 Cronbach's α 系数检验量表内部一致性。结果显示,总量表 Cronbach's α=0.812,各维度 α 介于 0.746~0.854,整体具有良好的内部一致性。
完整的题项数、CITC 和删除后 α 应以结果表为准。
图形
信度分析的核心证据是信度表和题项诊断表,图形不是必须结果。可结合:
- 描述性统计均值图.png。
- 缺失值统计图.png。
- 相关热力图或主模型图形。
没有专用信度图不影响 α、CITC 和删除题项后 α 的解释。
12. 有数据模式的操作建议
上传前
- 清理完全空白行列。
- 确认题项是数值编码。
- 确认每个题项量表范围。
- 标出反向题。
- 将题项归入正确维度。
- 把性别、年级、地区和 ID 标记为分类、控制或元数据。
- 同一维度至少准备 2 道题;需要题项诊断时建议至少 3 道。
- 不要把多个理论维度合并成一个维度只为了提高 α。
分析步骤
- 选择信度分析或问卷/量表基础分析。
- 选择有数据方式并准备数据文件和编码表。
- 确认题项、维度和反向题是否识别正确。
- 检查数据中的缺失值、特殊编码和量表范围。
- 计算并阅读各维度 α、CITC 和删除题项后的 α。
- 结合题目内容、理论结构和后续效度分析决定是否调整题项。
α 偏低时的排查顺序
- 检查反向题标记。
- 检查反向题的量表上下限是否为理论范围。
- 检查题项是否误归入同一维度。
- 检查缺失值和特殊编码。
- 查看 CITC 是否有负值或明显偏低值。
- 对照题项含义判断是否为内容差异。
- 必要时结合 EFA/CFA,不要只凭 α 删除题项。
13. 结果表述边界
可以表述
- 某维度包含多少题项。
- 某维度或总量表 α。
- 某题 CITC。
- 删除某题后 α 是否上升。
- 哪些题项需要结合题意复核。
- α 使用了多少完整案例。
示例:
“服务质量”维度包含 4 个题项,完整案例计算得到 Cronbach's α=0.812。各题 CITC 均为正,删除任一题项后的 α 未明显上升,因此暂未仅依据统计指标删除题项。结果仍需结合题项内容和量表结构复核。
不应直接表述
不能只依据 α 写:
- 问卷绝对可靠。
- 量表一定有效。
- 量表一定是单维的。
- 所有题项都必须保留。
- α 高就代表研究假设成立。
- α 低就一定要删除某题。
14. 与其他模型的关系
| 后续模型 | 信度结果的作用 |
|---|---|
| Pearson/Spearman 相关 | 判断使用题项还是维度得分 |
| t 检验/ANOVA | 检查用于比较的维度得分 |
| EFA | α 提供一致性信息,但不能替代因子结构 |
| CFA | α 是内部一致性参考,还需看载荷、拟合和效度 |
| SEM | 信度是测量模型解释的一部分,不等于路径成立 |
| 中介/调节 | X、M/Z、Y 为多题项构念时先检查题项质量 |
| 回归/Logistic | 维度得分进入模型前检查编码和缺失 |
信度、效度和因果关系是不同问题:
- 信度:题项是否较一致。
- 聚合效度:同一潜变量题项是否聚合。
- 区分效度:不同潜变量能否区分。
- 内容效度:题项是否覆盖理论概念。
- 结构效度:题项结构是否符合设定模型。