相关分析(Pearson / Spearman)
Pearson / Spearman 相关矩阵与显著性。
本模型一次分析会同时输出「Pearson 相关分析」与「Spearman 等级相关分析」两部分结果,下面分别说明。
1. Pearson 相关分析
方法概述
(1)Pearson 相关分析用于衡量两个数值变量之间线性关系的方向和强度。它回答的是:当一个变量取值较高或较低时,另一个变量是否也倾向于同步变化。
(2)Pearson 相关适合连续变量、近似连续的量表得分,或多个问卷维度得分之间的初步关系分析。相关系数的范围为 -1 到 1:正值表示同向变化,负值表示反向变化,绝对值越大表示线性关系越强。
(3)Pearson 相关不是回归,也不是因果分析。相关显著只能说明样本中存在统计上的线性关联,不能说明一个变量导致另一个变量变化。
适用问题与不适用问题
适用问题
Pearson 相关可以用于初步研究:
- 服务质量与满意度是否呈线性关联;
- 学习投入与成绩是否呈线性关联;
- 不同问卷维度得分之间是否有关联;
- 回归分析前自变量和因变量的基础关系;
- 多个连续变量之间是否存在高度相关。
不适用或需要谨慎的情况
以下情况不能直接把 Pearson 结果当作可靠结论:
- 变量是无序类别,如性别、专业或地区名称;
- 用 1、2、3 代表类别,却把类别代码当作连续距离;
- 变量之间是明显弯曲、U 型或倒 U 型关系;
- 存在严重异常值;
- 某个变量几乎没有变化;
- 有效样本量太小;
- 特殊缺失编码仍被当作有效数值。
两个分类变量的关联应考虑卡方检验;等级变量、非正态变量或只满足单调关系时,可考虑 Spearman 等级相关。
数据结构和输入要求
数据应按“每行一个观测、每列一个变量”整理。例如:
| 编号 | 服务质量 | 满意度 | 使用意愿 | 性别 |
|---|---|---|---|---|
| 1 | 4.2 | 4.0 | 4.5 | 男 |
| 2 | 3.1 | 3.5 | 3.2 | 女 |
| 3 | 4.8 | 4.6 | 4.7 | 男 |
服务质量、满意度和使用意愿可以作为数值变量;性别是分类变量,不应直接参与 Pearson 相关。
如果使用问卷数据,建议:
- 先检查反向题并统一计分方向;
- 明确每道题属于哪个维度;
- 在需要时计算维度得分;
- 将性别、地区、专业、编号等列标记为分类或识别变量;
- 处理 99、999、-1 等特殊缺失编码。
相关分析至少需要两个有变异的数值变量。变量过多时,建议按研究问题或理论维度分组,不要把所有列无目的地放在同一张相关矩阵中。
分析流程
如果变量存在缺失,不同变量对可能使用不同的有效样本量。报告相关结果时应同时关注每一对变量的有效样本量。
Pearson 相关系数公式
设两个变量 X 和 Y 有 n 对有效观测:
均值
协方差和标准差
样本协方差为:
样本标准差分别为:
Pearson 相关系数
Pearson 样本相关系数为:
等价形式为:
其取值范围为:
如果任一变量的标准差为 0,相关系数没有定义,不能把这种情况写成“没有相关”。
显著性检验
假设
双侧检验通常设为:
其中 \rho 是总体相关系数,r 是样本相关系数。
t 统计量和 p 值
当有效配对样本量为 n,且 |r|<1 时:
自由度为:
双侧 p 值为 t 分布两侧尾部概率:
通常把 p<0.05 作为统计显著的参考,但显著性水平应在研究设计中事先确定。
显著性星号
常见标记方式为:
| p 值 | 标记 |
|---|---|
| p < 0.001 | *** |
| 0.001 ≤ p < 0.01 | ** |
| 0.01 ≤ p < 0.05 | * |
| p ≥ 0.05 | 不加星号 |
星号只表示统计检验阈值,不表示相关强度。报告时应同时给出 r、p 和有效样本量。
缺失值和有效样本量
对每一对变量 X,Y,只保留二者同时有有效值的观测:
有效配对样本量为:
例如,A 与 B 可能有 180 对有效观测,A 与 C 可能只有 172 对。不同相关系数的样本基础不完全相同时,不能不加说明地把它们当成同一批完整样本的结果。
分析前应:
- 区分真正缺失和有效的 0 分;
- 处理 99、999、-1 等特殊编码;
- 检查缺失是否集中在某些题项或人群;
- 查看每对变量的有效样本量;
- 不根据一个固定缺失比例自动决定删除或填补。
结果表格和图形的阅读方法
系统输出的工作表(analysis_tables.xlsx):相关矩阵、相关显著性、显著性标记、Spearman相关、Spearman显著性、Spearman显著标记、描述性统计、缺失值报告。
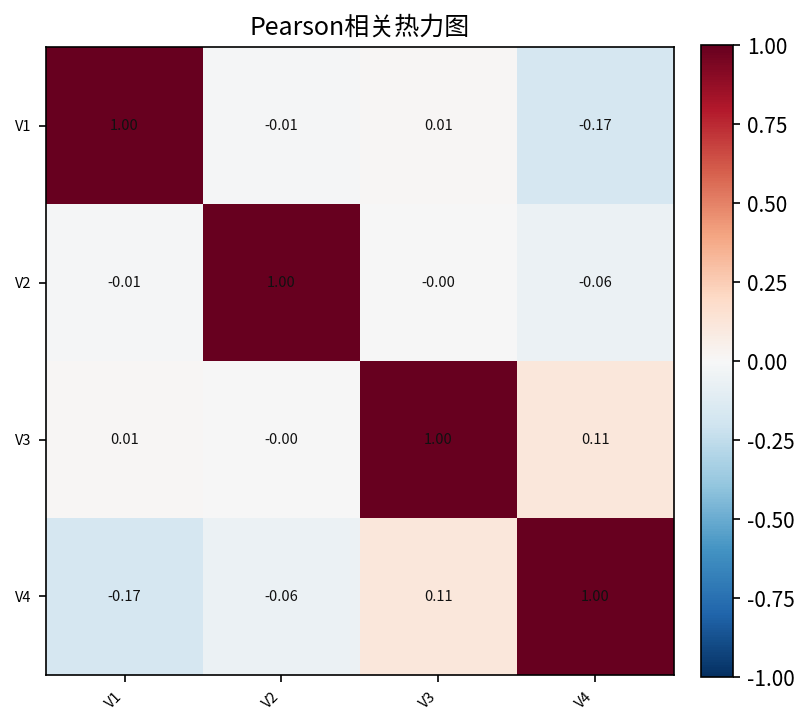
示例(来自系统结果包,示例数据)。
相关矩阵表:
| 变量 | V1 | V2 | V3 | V4 |
|---|---|---|---|---|
| V1 | 1 | -0.0096 | 0.0082 | -0.1684 |
| V2 | -0.0096 | 1 | -0.0011 | -0.0613 |
| V3 | 0.0082 | -0.0011 | 1 | 0.1106 |
| V4 | -0.1684 | -0.0613 | 0.1106 | 1 |
相关矩阵
相关矩阵以变量为行和列,单元格为 r:
- 对角线通常为 1;
- 上下三角通常对称;
- 正值和负值表示不同方向;
- 空白可能表示共同有效观测不足、常量列或无法计算;
- 精确数值应以相关系数表为准。
显著性表
显著性表给出每一对变量的双侧 p 值。p 值不是相关系数,也不是关系强度。带星号的矩阵便于快速查看,但正式整理时应保留相关系数和 p 值两个结果。
相关热力图
热力图用颜色表示相关方向和强度,适合快速寻找高度相关的变量对。图形不能替代数值表,也不能仅凭颜色判断统计显著性。
简要结果说明
结果说明可以写成:
Pearson 相关分析显示,服务质量与使用意愿呈中等程度正相关(r=0.463,p<0.01,n=320)。这表示在本样本中,服务质量得分较高的记录通常也具有较高的使用意愿得分。
其中 n 应替换为该变量对的实际有效样本量。
如何解释相关系数
方向
- r>0:X 较高时,Y 通常也倾向较高;
- r<0:X 较高时,Y 通常倾向较低;
- r\approx0:没有明显线性同步变化,但可能存在非线性关系。
方向必须结合变量编码解释。反向题未处理时,方向可能与理论预期相反。
强度
以下区间只能作为初步阅读参考:
| \( | r | \) | 初步理解 |
|---|---|---|---|
| 0.00 至 0.19 | 很弱或接近无 | ||
| 0.20 至 0.39 | 较弱 | ||
| 0.40 至 0.59 | 中等 | ||
| 0.60 至 0.79 | 较强 | ||
| 0.80 至 1.00 | 很强 |
强度还受测量可靠性、变量范围、研究领域和样本设计影响,不能机械套用。
显著性和实际意义
样本量很大时,较小的相关也可能显著;样本量较小时,中等相关也可能不显著。因此应同时报告 r、p、有效样本量和研究背景。
相关不是因果
相关分析不能直接说明:
- X 导致 Y;
- Y 导致 X;
- X 和 Y 之间存在单向影响;
- 控制其他变量后关系仍然成立;
- 关系可以推广到所有人群。
相关可能来自第三个变量、样本选择、共同测量方法、极端值或变量编码错误。如果研究问题是“X 是否预测 Y”,应考虑回归模型;如果研究问题是机制路径,应考虑中介、调节或结构模型。
有真实数据时的使用步骤
- 明确要分析的变量关系和理论方向。
- 选择连续变量、量表维度得分或适合近似连续处理的变量。
- 检查分类编码、反向题、特殊缺失和异常值。
- 准备数据,必要时提供问卷编码表。
- 确认参与分析的列名和变量含义。
- 查看描述性统计和缺失情况。
- 阅读相关矩阵、p 值、显著性标记和热力图。
- 在结果中同时报告相关系数、p 值和有效样本量。
常见问题
为什么相关矩阵没有结果?
可能只有一个可用数值变量、有效配对样本不足、变量几乎全部缺失、变量为常量列,或分类变量被正确排除。应先检查数据结构和变量类型。
为什么矩阵中有空白?
可能是两个变量的共同有效观测不足、其中一个变量没有变异或特殊字符被识别为缺失。空白不等于相关系数为 0。
为什么性别等变量进入相关矩阵?
数字编码的分类变量不应直接作为连续变量解释。应检查变量类型和编码表,必要时将其改为分类变量或从相关分析中排除。
为什么相关很高但不显著?
有效样本量可能较小,或该变量对的共同有效观测太少。应同时查看 r、p 和 n。
为什么 Pearson 和 Spearman 结果不同?
Pearson 分析原始数值的线性关系,Spearman 先将数值转换为秩后分析单调关系。异常值、非正态、等级变量和非线性关系都可能造成差异。应依据数据类型和研究问题选择,而不是挑选更符合预期的结果。
结果表述边界
可以表述:
在本样本中,服务质量与使用意愿呈中等程度正相关,且相关检验达到统计显著。这说明两者存在同向线性关联。
不应仅凭 Pearson 相关表述:
服务质量显著影响使用意愿。
与其他模型的关系
| 模型 | Pearson 相关的作用 |
|---|---|
| 描述性统计 | 先确认有效样本、范围和离散程度 |
| 信度分析 | 查看题项和维度间的基础关联 |
| t 检验/ANOVA | 不替代组间均值差异检验 |
| 线性回归 | 提供预测关系的基础探索,但不等于回归系数 |
| Logistic 回归 | 不替代分类结果建模 |
| EFA | 相关结构是因子提取的基础之一,但不等于因子结构已经确定 |
| CFA/SEM | 可作为测量和结构建模前的基础检查 |
| 中介/调节 | 不能用简单相关替代间接效应或交互效应 |
| 卡方检验 | 分类变量关联使用列联表和卡方方法 |
2. Spearman 等级相关分析
方法概述
(1)Spearman 等级相关分析用于衡量两个变量之间单调关系的方向和强度。它不要求变量之间必须是严格直线关系,而是考察:当一个变量的取值或等级总体上升时,另一个变量是否也总体上升或下降。
(2)Spearman 相关系数通常记为 \rho 或 r_s。它先把原始数值转换为秩次,再对秩次进行 Pearson 相关计算。因此,变量的原始单位不会直接影响结果,异常值的影响通常也比 Pearson 相关小一些。
(3)它适合等级数据、问卷等级题、明显偏态的数值数据,以及关系大致单调但不一定是直线的情况。Spearman 相关仍然只是关联分析,不能证明一个变量导致另一个变量变化。
适用问题与不适用问题
适用问题
Spearman 相关可以用于:
- 两个有序等级变量之间的关系;
- 单题 Likert 等级题之间的关系;
- 数据明显偏态但仍具有单调趋势;
- 数据中存在少量极端值,担心 Pearson 相关过度受影响;
- 研究问题只关心“总体上升或下降”,不要求关系为直线;
- 样本量较小但变量至少具有合理的排序信息。
例如:
- 服务评价等级与再次购买意愿等级是否同向;
- 学习投入排名与成绩排名是否相关;
- 等待时间等级与满意度等级是否反向相关;
- 两个问卷维度的等级得分是否呈单调关系。
不适用或需要谨慎的情况
以下情况不宜直接使用 Spearman 相关:
- 变量是没有顺序的类别,例如专业名称、地区名称;
- 类别编码的数字没有大小关系;
- 样本中某个变量几乎所有值都相同;
- 两个变量没有来自同一批观测对象;
- 数据中存在大量并列值,且可区分的等级非常少;
- 研究问题要求解释原始单位的线性变化;
- 研究问题实际上是比较组均值、预测二分类结果或检验中介机制。
无序分类变量的关联通常考虑卡方检验;连续变量的线性关系可以考虑 Pearson 相关;预测问题需要回归模型;因果或机制问题需要与研究设计相匹配的模型。
Pearson 与 Spearman 如何选择
| 比较方面 | Pearson 相关 | Spearman 等级相关 |
|---|---|---|
| 计算对象 | 原始数值 | 数值转换后的秩次 |
| 主要关系 | 线性关系 | 单调关系 |
| 数据类型 | 连续或近似连续 | 等级、连续或偏态数据 |
| 异常值影响 | 通常较明显 | 通常相对较小,但并非完全没有影响 |
| 是否要求正态 | 严格推断时通常要检查 | 对分布形态要求相对宽松 |
| 是否表示因果 | 都不表示 | 都不表示 |
选择方法时应根据变量性质和研究问题,而不是选择更容易得到显著结果的方法。同一批数据同时报告两种方法时,应说明两种方法的使用理由。
数据结构和输入要求
数据应按“每行一个观测、每列一个变量”整理。例如:
| 编号 | 服务评价等级 | 满意度等级 | 使用意愿等级 |
|---|---|---|---|
| 1 | 4 | 4 | 5 |
| 2 | 2 | 3 | 2 |
| 3 | 5 | 5 | 5 |
准备数据时应注意:
- 每行代表同一个受访者、实验单位或观测对象。
- 每列代表一个有明确顺序的变量。
- 1、2、3、4、5 必须有明确的等级含义,不能只是无序类别的代码。
- 缺失值、拒答和“不适用”应与有效等级区分。
- 如果是问卷题,应确认反向题是否需要先统一方向。
- 如果使用多个题项形成维度得分,应在计算维度得分前明确题项归属和计分方向。
Spearman 相关至少需要两个有变异的变量。样本过少、变量几乎全为同一个等级或两列没有共同有效观测时,相关系数可能无法稳定计算。
分析流程
Spearman 相关考察的是排序是否一致。即使原始数值之间的差距不相等,只要排序大致一致,仍可能得到较高的等级相关。
秩次转换
没有并列值时
设变量 X 有 n 个观测。将观测从小到大排序后,最小值的秩为 1,最大值的秩为 n。记第 i 个观测的秩为 R_i。
例如,原始数据为:
| 观测 | 原始值 | 秩 |
|---|---|---|
| A | 12 | 2 |
| B | 8 | 1 |
| C | 20 | 4 |
| D | 15 | 3 |
如果另一个变量 Y 的秩为 S_i,Spearman 相关就是 R_i 与 S_i 的 Pearson 相关。
存在并列值时
如果多个观测的原始值相同,它们获得平均秩。例如,排序后某个值占据第 2、3、4 位,则三个相同值都使用:
作为秩次。
这种方法保留了并列值的共同位置,适用于问卷中大量受访者选择相同等级的情况。
反向题和秩次方向
如果一个题项分数越高表示态度越差,而另一个变量分数越高表示态度越好,需要在分析前统一方向。否则,原本同向的关系可能被计算成负向,或原本负向的关系被抵消。
对于量表最小值 L、最大值 U 的反向题,可以使用:
反向计分不是为了改变结果方向来追求显著,而是为了让同一构念的分数方向具有一致含义。
Spearman 相关系数公式
设 X 和 Y 有 n 对共同有效观测,分别转换为秩次 R_i 和 S_i。
一般公式:秩次的 Pearson 相关
最一般的定义是:
其中:
- R_i:第 i 个观测在变量 X 中的秩;
- S_i:第 i 个观测在变量 Y 中的秩;
- \bar{R}:秩 R_i 的平均值;
- \bar{S}:秩 S_i 的平均值。
存在并列值时,应使用平均秩,并采用这个一般公式。
无并列值时的简化公式
当两个变量都没有并列秩时,令:
Spearman 相关可以写为:
如果存在并列值,不应机械使用这个简化式,而应使用平均秩后的 Pearson 相关公式。
取值范围和含义
- r_s>0:两个变量总体上同向排序;
- r_s<0:一个变量排名较高时,另一个变量总体上排名较低;
- r_s\approx0:没有明显的单调关系。
接近 0 只表示没有明显单调关系,并不能排除 U 型、倒 U 型等非单调关系。
显著性检验
假设
双侧检验通常设为:
其中 \rho_s 是总体 Spearman 等级相关系数,r_s 是样本等级相关系数。
t 近似
在样本量满足近似条件时,可以使用:
自由度为:
双侧 p 值为:
小样本、并列秩很多或研究需要精确推断时,可以考虑置换检验或精确方法,并在方法部分说明。
显著性标记
常见标记方式为:
| p 值 | 标记 |
|---|---|
| p < 0.001 | *** |
| 0.001 ≤ p < 0.01 | ** |
| 0.01 ≤ p < 0.05 | * |
| p ≥ 0.05 | 不加星号 |
星号只表示统计显著性,不表示等级关系的强度或实际重要性。
缺失值和有效样本量
对于变量 X 与 Y,只使用二者同时有有效值的观测:
有效样本量为:
当多个变量两两计算等级相关时,不同变量对的 n 可能不同。结果表应尽量同时提供每一对变量的有效样本量,至少在结果说明中交代样本基础。
分析前应检查:
- 空白、拒答和不适用是否被正确识别;
- 99、999、-1 等编码是否为缺失;
- 有效等级是否确实具有顺序;
- 某个等级是否占绝大多数;
- 缺失是否集中在特定题项或人群。
结果表格和图形的阅读方法
系统输出的工作表(analysis_tables.xlsx):Spearman相关、Spearman显著性、Spearman显著标记;同时输出相关矩阵、相关显著性、显著性标记。
等级相关矩阵
矩阵中的单元格为 r_s:
- 对角线通常为 1;
- 上下三角通常对称;
- 正值表示同向排序,负值表示反向排序;
- 空白可能表示共同有效样本不足、无变异或无法形成秩次;
- 精确数值应结合显著性表和有效样本量阅读。
显著性表
显著性表给出每一对变量的双侧 p 值。p 值不表示相关强度,不能单独用“显著”替代对 r_s 大小的说明。
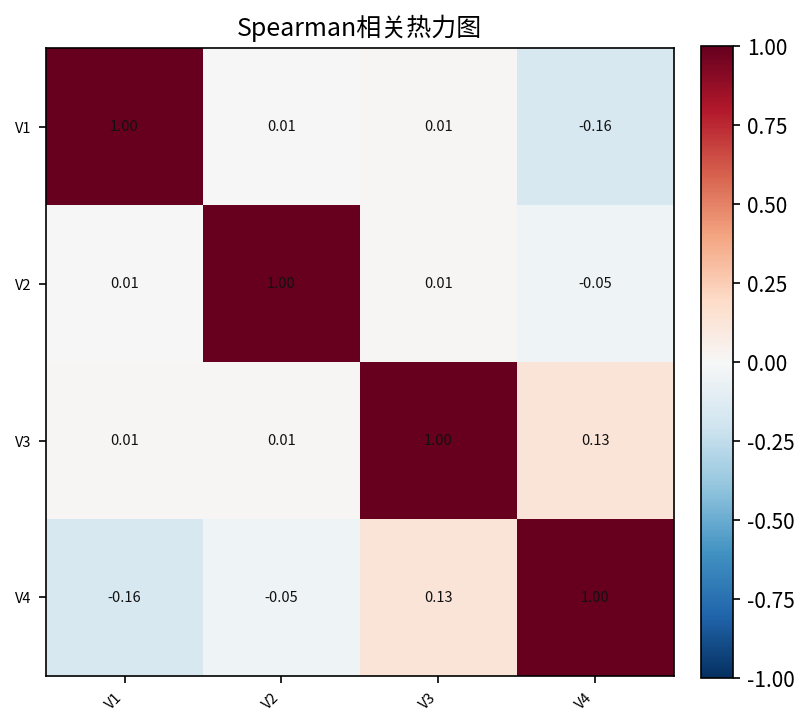
热力图
等级相关热力图可以快速展示变量之间的正负方向和相对强弱。热力图适合发现模式,不替代表格中的系数、p 值和有效样本量。
结果说明示例
可以写:
Spearman 等级相关分析显示,服务评价等级与再次购买意愿等级呈中等程度正相关(r_s=0.421,p<0.01,n=280)。这表示在本样本中,服务评价等级较高的观测通常也具有较高的再次购买意愿等级。
如果关系不显著,可以写:
服务评价等级与再次购买意愿等级的等级相关系数为 r_s=0.121,未达到预先设定的显著性水平,当前样本不足以支持存在明确单调关系的判断。
如何解释等级相关强度
以下区间只用于初步阅读:
| \( | r_s | \) | 初步理解 |
|---|---|---|---|
| 0.00 至 0.19 | 很弱或接近无 | ||
| 0.20 至 0.39 | 较弱 | ||
| 0.40 至 0.59 | 中等 | ||
| 0.60 至 0.79 | 较强 | ||
| 0.80 至 1.00 | 很强 |
不同研究领域的判断标准可能不同。关系强度还应结合量表可靠性、样本量、并列等级数量和研究背景解释。
有真实数据时的使用步骤
- 明确两个变量是否具有明确的顺序关系。
- 选择等级变量、偏态变量或单调关系变量。
- 检查反向题、特殊缺失和无序类别编码。
- 准备数据,必要时提供题项和维度说明。
- 确认变量的方向和有效等级。
- 查看描述性统计、频数分布和缺失情况。
- 阅读等级相关系数、p 值、有效样本量和热力图。
- 同时报告 r_s、p 值和有效样本量,不把等级相关写成因果关系。
常见问题
为什么等级相关没有结果?
可能只有一个可用变量、共同有效观测过少、变量全部相同、变量没有明确排序,或有效值在转换后几乎全部缺失。
为什么相关系数接近 0?
可能没有单调关系,也可能存在 U 型、倒 U 型等非单调关系。建议结合散点图、分组图或理论判断,不要把 r_s\approx0 写成“两个变量完全没有关系”。
并列等级很多会有什么影响?
并列值会降低可区分的排序信息,可能影响系数大小和显著性。应报告变量的等级分布,并谨慎解释只有少数几个等级的结果。
为什么 Pearson 和 Spearman 结果不同?
Pearson 使用原始数值并关注直线关系,Spearman 使用秩次并关注单调关系。异常值、偏态、等级变量和非线性都会造成差异。两者不同不代表其中一个必然错误。
数字编码的性别可以做 Spearman 吗?
如果 1 和 2 只是男、女的无序标签,就不能把它们当成等级变量。只有变量类别本身具有明确顺序时,才适合做等级相关。
结果表述边界
可以表述:
在本样本中,两个变量呈显著正向单调关联,即一个变量的等级较高时,另一个变量的等级通常也较高。
不应仅凭 Spearman 相关表述:
X 显著影响 Y。
等级相关不提供方向性因果证据,也不能替代回归、实验设计或纵向分析。
与其他模型的关系
| 模型 | Spearman 相关的作用 |
|---|---|
| 描述性统计 | 查看等级分布、频数、缺失和集中趋势 |
| Pearson 相关 | 当变量接近连续且重点是线性关系时使用 |
| 卡方检验 | 无序分类变量之间的关联使用列联表方法 |
| t 检验/ANOVA | 比较组间均值,不能用等级相关替代 |
| 线性回归 | 研究连续结果的预测关系,不能用等级相关替代 |
| Logistic 回归 | 研究二分类结果的预测关系 |
| EFA | 检查题项的潜在因子结构,不能只用等级相关下结论 |
| 中介/调节 | 检验机制或交互作用,不能用简单等级相关替代 |