线性回归
用自变量预测连续结果。
1. 方法概述
(1)线性回归用于研究一个连续结果变量与一个或多个解释变量之间的线性关系。它可以回答:在控制其他变量后,某个解释变量的变化与结果变量的平均变化有什么关系。
(2)简单线性回归只有一个解释变量,多元线性回归可以同时纳入多个解释变量和控制变量。回归结果包括模型整体解释力、各解释变量的系数、置信区间和显著性检验。
(3)回归系数反映条件关联。除非研究设计能够排除混杂、反向因果和选择偏差,否则不能仅凭回归结果断言因果关系。
2. 适用问题与不适用问题
适用问题
- 结果变量是连续数值,或在研究设计中可近似按连续变量处理;
- 研究关注多个解释变量与结果变量的线性关系;
- 每一行是一个独立观测对象;
- 解释变量和结果变量具有明确的理论含义。
不适用或需要改用其他方法的情况
- 结果变量是二分类:考虑二元 Logistic 回归;
- 结果变量是计数且偏态明显:考虑计数回归;
- 同一对象有重复测量或数据具有明显层级结构:考虑混合效应模型;
- 关系明显非线性且没有合理变换:考虑非线性模型、样条或加入有理论依据的非线性项;
- 解释变量之间高度重复:先处理多重共线性,不能只看单个 p 值。
3. 数据结构和输入要求
数据按“每行一个观测、每列一个变量”整理。最少包括一列连续结果变量和一列或多列解释变量。
| 编号 | 学习时间 | 出勤率 | 成绩 |
|---|---|---|---|
| 1 | 12 | 0.95 | 86 |
| 2 | 7 | 0.80 | 72 |
| 3 | 15 | 1.00 | 94 |
分类解释变量需要使用有明确含义的虚拟变量或合理编码。无序类别不能直接用 1、2、3 当作具有线性距离的连续变量。连续变量的单位应清楚,例如学习时间是小时还是分钟。
在建立模型前,应明确结果变量、主要解释变量、控制变量以及变量方向。缺失值处理会影响实际样本量,不同模型的有效样本量可能不同。
4. 分析流程
5. 回归模型与最小二乘估计
含 p 个解释变量的总体模型为:
其中 Y_i 是第 i 个观测的结果,X_{ij} 是解释变量,\beta_0 是截距,\beta_j 是在其他变量保持不变时 X_j 的条件斜率,\varepsilon_i 是误差项。
样本中的预测值和残差为:
普通最小二乘法通过最小化残差平方和估计系数:
矩阵形式为:
前提是设计矩阵具有足够的秩,且不存在完全线性依赖。
6. 模型解释力和整体检验
总平方和、回归平方和和残差平方和分别为:
三者满足:
决定系数为:
调整后的决定系数为:
整体 F 检验通常检验:
其统计量为:
整体显著表示模型中的解释变量联合起来提供了超出空模型的信息,但不表示每个变量的系数都显著。
7. 回归系数和显著性检验
第 j 个回归系数的 t 统计量为:
在经典假设下,自由度为 n-p-1,双侧 p 值用于检验:
连续变量的系数表示“该变量增加一个原始单位时,结果变量的预测均值平均改变多少”,前提是其他解释变量保持不变。标准化系数便于比较不同量纲变量的相对关系,但不能替代原始单位系数。
8. 诊断与稳健性
应至少检查:
- 线性关系:解释变量与结果的条件关系是否近似线性;
- 独立性:观测是否来自相互独立的对象;
- 方差齐性:残差的波动是否随预测值明显变化;
- 残差分布:正态性主要影响小样本下的区间和 p 值推断;
- 多重共线性:解释变量之间是否高度相关;
- 影响点:少数观测是否过度改变回归系数。
方差膨胀因子(VIF)为:
其中 R_j^2 是用其他解释变量预测 X_j 得到的决定系数。VIF 较高表示系数可能不稳定,应结合相关矩阵和理论判断,不能只依靠一个阈值机械删变量。
残差图、预测值与观测值图、Q-Q 图、杠杆值和 Cook 距离有助于识别模型问题。发现异常点后,应先核查数据质量和研究对象,不应为了改变显著性而任意删除。
9. 结果表格和图形的阅读方法
系统输出的工作表(analysis_tables.xlsx):线性回归系数、线性回归模型摘要、描述性统计、相关矩阵、相关显著性、显著性标记、缺失值报告。
示例(来自系统结果包,示例数据)。
线性回归系数表:
| 结果变量 | 预测变量 | 回归系数 | β | SE | t | p | VIF |
|---|---|---|---|---|---|---|---|
| Y | 截距 | -0.015416 | — | 0.057514 | -0.268 | 0.788949 | |
| Y | X1 | 0.849253 | 0.653907 | 0.057079 | 14.8786 | <0.001 | 1.006168 |
线性回归模型摘要表:
| 结果变量 | n | R² | 调整R² | 最大VIF | Durbin-Watson |
|---|---|---|---|---|---|
| Y | 200 | 0.623735 | 0.617976 | 1.010647 | 1.96427 |
建议包括:
- 模型摘要:R^2、调整 R^2、有效样本量,以及残差均值、残差标准差、偏度、峰度、JB 检验和 Durbin-Watson;
- 系数表:回归系数、β(标准化系数)、SE、t、p、置信区间和 VIF;
- 多重共线性:VIF(模型摘要同时给出最大 VIF 和 VIF 大于 5 的变量数);
- 图形:回归散点图、回归系数图和回归残差诊断图。
系统结果包中的实际图形(示例数据):
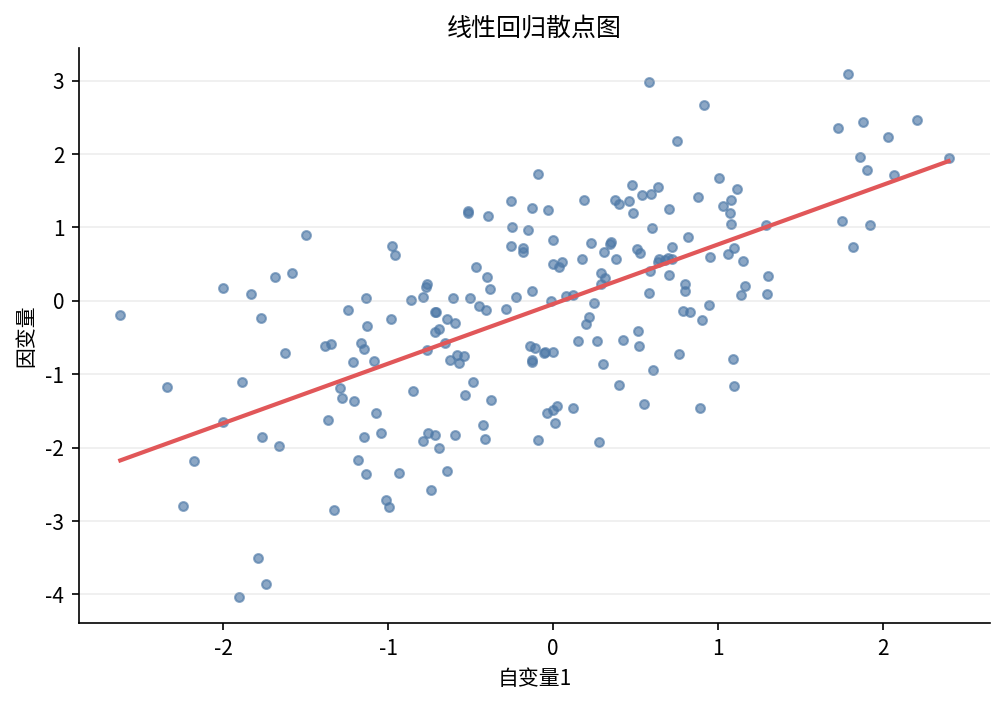
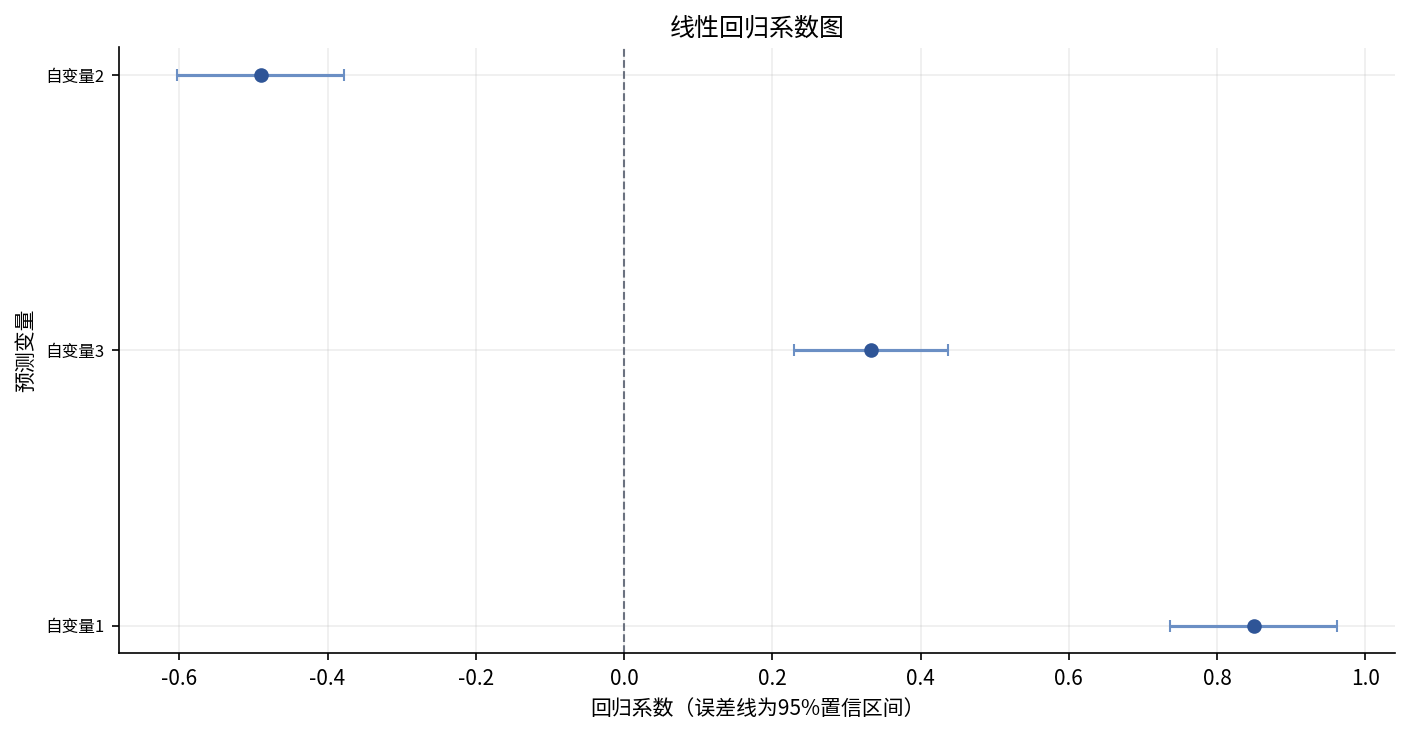
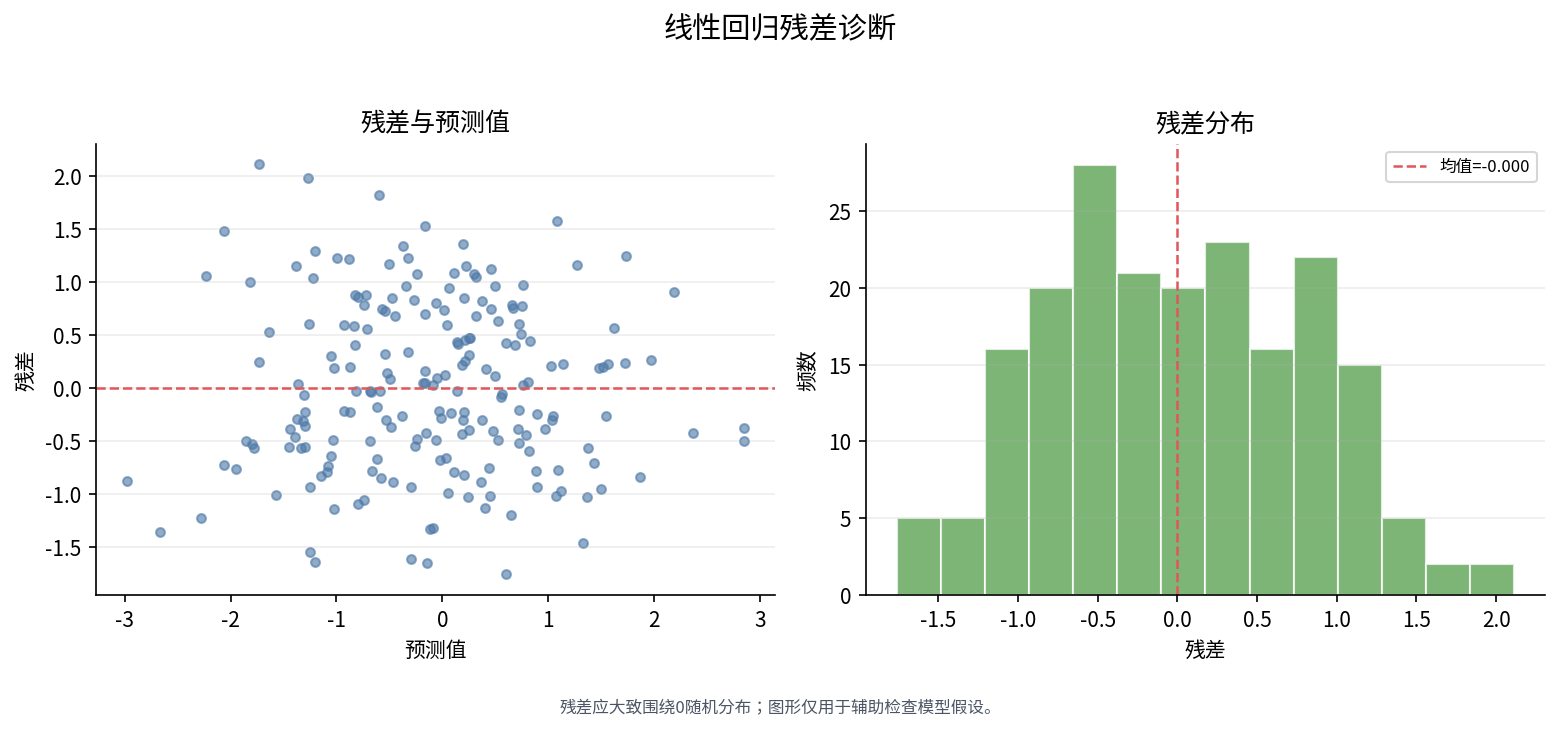
10. 结果表述边界
可以表述为:“在控制年龄和出勤率后,学习时间每增加 1 小时,成绩预测值平均增加 \beta=... 分,95% 置信区间为 [...],p=...。模型调整后 R^2=...。”
除非有明确的实验或纵向设计,不应把“预测值增加”直接写成“学习时间导致成绩增加”。高 R^2 也不等于模型结构正确,更不等于因果关系成立。
11. 常见问题
- 整体 F 检验显著但某个变量不显著:整体检验与单个系数检验不同,可能存在变量重叠或共线性。
- 增加变量后 R^2 几乎不会下降:普通 R^2 不会因增加变量而下降,应同时看调整 R^2 和交叉验证表现。
- VIF 高仍只看 p 值:共线性会放大标准误,系数方向和大小可能不稳定。
- 只根据残差正态图判断模型可用:还需检查线性、独立性、方差齐性和影响点。