问卷基础分析(EFA)
探索题项背后的潜在维度结构(问卷基础分析的主结果)。
本教程对应主模型 001 问卷基础分析。该模型一次会输出:描述性统计、信度分析、相关矩阵和 EFA 探索性因子分析。
其中「描述性统计」见通用教程《描述性统计》,「信度分析」见量表类共用教程《信度分析》;「相关矩阵」和「EFA」在本篇说明。
1. 方法概述
(1)探索性因子分析(Exploratory Factor Analysis,EFA)用于探索多道观测题项背后可能存在的少数潜在维度。它把题项之间的相关关系概括为若干潜在因子,帮助研究者了解量表结构、题项归属和维度数量。
(2)EFA 是探索性方法,不是把预设理论模型强行验证为正确。因子数量、旋转方式和题项保留应同时参考理论、样本特征、载荷、共同度和解释力,不能只根据“哪个结果更好看”决定。
2. 适用问题与不适用问题
适用情形:
- 有多道测量同一较宽泛构念的题项;
- 题项之间存在合理相关;
- 研究者希望探索潜在维度结构;
- 每道题项具有足够的有效数值观测。
不适用或需要谨慎:
- 只有两三道完全不同概念的变量;
- 题项之间几乎没有相关;
- 样本量相对于题项数过小;
- 已有明确理论测量模型且目标是检验其匹配度:应考虑 CFA;
- 把性别、年龄、地区、编号等非量表变量与题项混合分析。
3. 数据结构和输入要求
每行是一名受访者,每列是一道数值题项。例如 Q1 至 Q15 为 1-5 级量表。反向题应先统一方向,缺失值和特殊编码应明确。
题项数量、样本量和共同度共同影响结果稳定性。没有一个适用于所有研究的固定样本量,但题项越多、共同度越低、因子载荷越弱,就越需要更大的样本。
如果同时上传编码表,系统会按“维度”把题项分组,同一维度的题项一起参与因子结构说明;每个维度至少有 3 个题项时,得到的因子结构更稳定、也更便于命名。
4. 分析流程
5. KMO 与 Bartlett 检验
KMO 指标比较简单相关和偏相关的相对大小:
其中 r_{ij} 是题项间相关,q_{ij} 是偏相关。KMO 越高通常表示共同因子结构更适合,但不能单凭一个阈值决定分析有效。
Bartlett 球形检验检验相关矩阵是否为单位矩阵。若拒绝原假设,说明题项间总体相关不全为零,具备进一步分析的基础。样本很大时,极小的相关也可能显著,因此仍需查看相关矩阵和实际载荷。
6. 因子模型与提取
常见共同因子模型为:
其中 \mathbf{x} 是观测题项,\mathbf{f} 是共同因子,\boldsymbol{\Lambda} 是因子载荷矩阵,\boldsymbol{\epsilon} 是独特性误差。
对第 i 道题项,可以写为:
共同度表示题项方差中可由共同因子解释的部分,独特度表示未被共同因子解释的部分。在标准化题项下,常见关系为:
主成分分析是数据降维方法,不等同于共同因子模型。若研究目的是真正探索潜在构念,应在方法说明中明确使用的提取方法。
7. 因子数和旋转
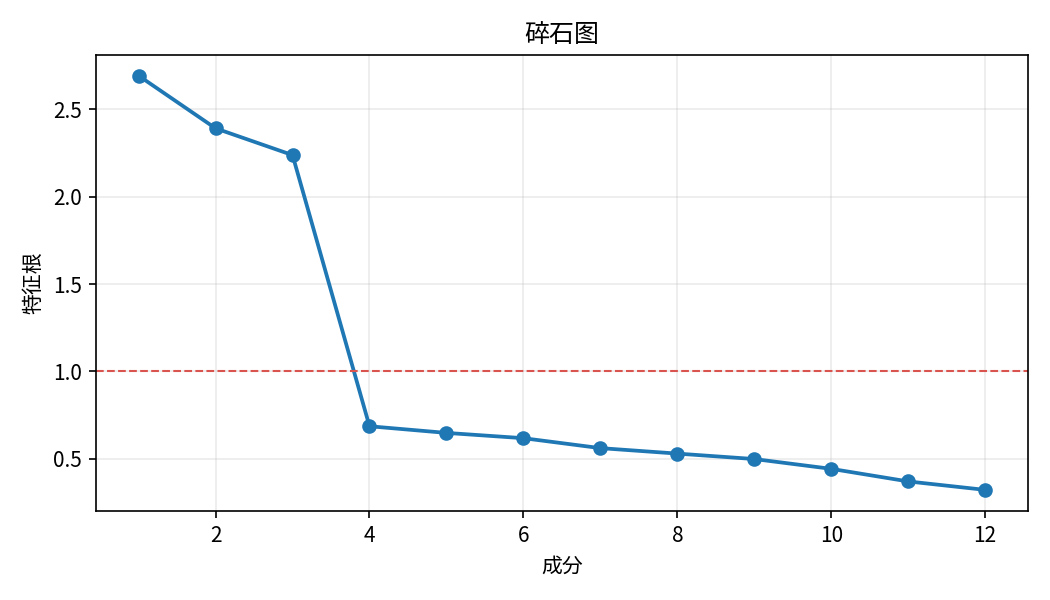
因子数可以综合考虑:平行分析、碎石图拐点、特征根、累计解释方差、理论维度和结果可解释性。特征根大于 1 只能作为参考,不能单独决定因子数。
如果潜在因子之间理论上可能相关,通常使用斜交旋转,并报告因子相关;如果有充分理由认为因子独立,可以考虑正交旋转。旋转不会改变共同解释的总方差,但会改变载荷的分配和可解释性。
8. 载荷、交叉载荷和题项处理
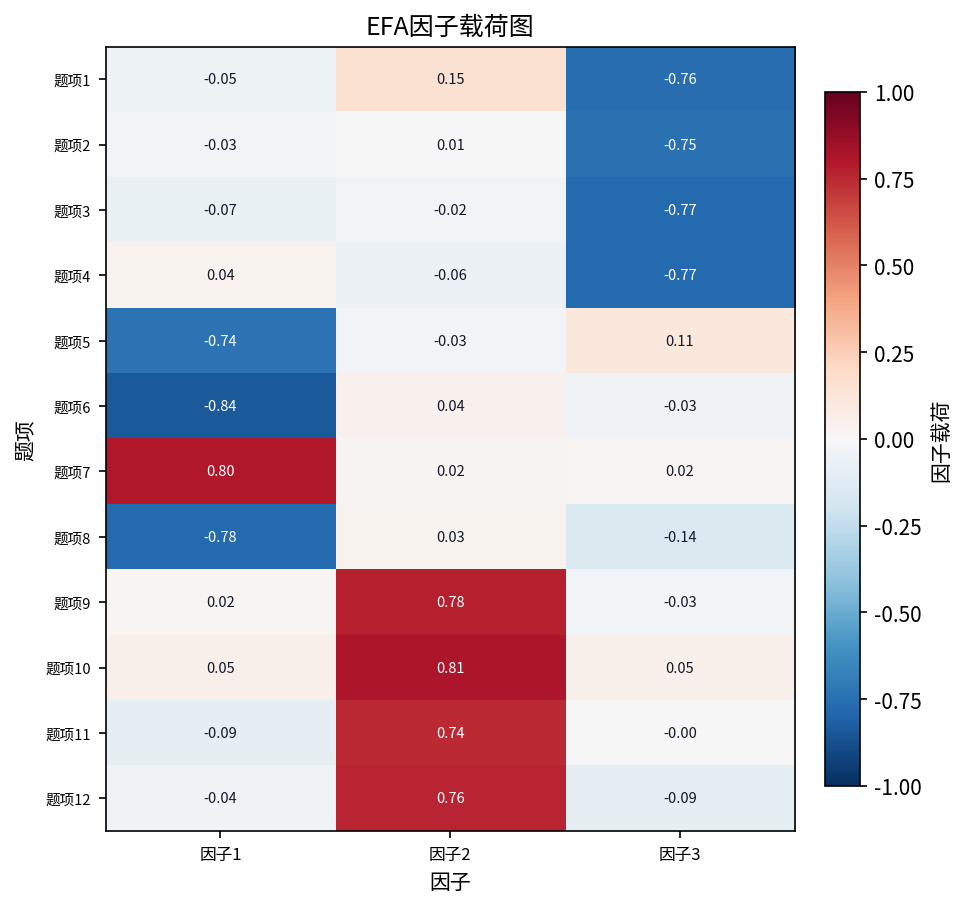
载荷绝对值较高通常表示题项与因子关系更强,但没有脱离样本量和理论的统一“合格线”。应同时关注:
- 主要载荷是否清晰;
- 一个题项是否在多个因子上都有较高载荷;
- 共同度是否过低;
- 删除题项是否破坏内容覆盖;
- 删除题项后结构是否依然符合理论。
不应为了提高某个指标而反复删除题项。每次调整都应记录理论理由,并在独立样本中验证。
9. 相关矩阵(Pearson / Spearman)
问卷基础分析在 EFA 之外,还会输出题项(或维度得分)之间的相关矩阵,用来快速查看变量之间的关联方向和强度。
(1)Pearson 相关系数 r 衡量两个数值变量之间的线性关系,取值在 -1 到 1 之间:接近 1 为正相关,接近 -1 为负相关,接近 0 表示线性关系弱。
(2)当变量是等级数据、分布明显偏态,或存在较多并列值时,改用 Spearman 等级相关 r_s:先对各变量排名,再对秩次计算相关。
(3)相关显著性表给出每一对变量的双侧 p 值。带星号的矩阵(*** 表示 p<0.001,** 表示 p<0.01,* 表示 p<0.05)便于快速浏览,但正式报告应同时给出相关系数、p 值和有效样本量。
(4)读相关矩阵时,先看方向和强度,再看显著性;相关只说明变量之间存在关联,不能说明因果或先后顺序。
系统输出的相关表:相关矩阵、相关显著性、显著性标记(Pearson)。若变量为等级或偏态数据,可在分析时参考 Spearman 等级相关的方法说明。
10. 结果表格和图形的阅读方法
系统输出的工作表(analysis_tables.xlsx):EFA摘要、KMO与Bartlett检验、特征根与碎石数据、因子载荷矩阵、因子命名建议、信度分析、信度题项分析、描述性统计、变量编码表、维度得分、相关矩阵、相关显著性、显著性标记、缺失值报告、频数统计。
示例(来自系统结果包,示例数据)。
因子载荷矩阵表:
| 变量名 | 维度 | F1 | F2 | F3 | 共同度 |
|---|---|---|---|---|---|
| Q1 | dim1 | -0.0535 | 0.1542 | -0.7646 | 0.611183 |
| Q2 | dim1 | -0.0287 | 0.0057 | -0.7454 | 0.556434 |
| Q3 | dim1 | -0.074 | -0.0248 | -0.7738 | 0.604909 |
建议输出:KMO 与 Bartlett 检验表、共同度表、特征根和解释方差表、旋转后的因子载荷矩阵、因子相关矩阵(如适用)以及碎石图或平行分析图。
碎石图用于观察因子数候选,不能单独证明某个因子数必然正确。因子命名应根据高载荷题项的共同内容完成,而不是根据程序自动生成的名称直接使用。
系统结果包中的实际图形(示例数据):
11. 结果表述边界
可以表述为:“KMO=...,Bartlett 球形检验显著,说明题项相关结构适合进一步探索。采用某提取方法和某旋转方法得到 m 个因子,累计解释方差为...,各题项的主要载荷见表。”
EFA 发现的是当前样本中的探索性结构,不能自动证明量表具有稳定效度,也不能把因子命名建议当作理论结论。
12. 常见问题
- KMO 高就说明因子数正确:KMO 只反映共同因子分析的适配基础,不决定因子数。
- 只用特征根大于 1 决定因子数:应结合平行分析、碎石图和理论。
- 使用未处理的反向题:会改变相关方向和因子结构。
- 把旋转后的载荷当作因果系数:因子载荷反映测量关系,不是因果效应。