描述性统计
了解样本量、缺失情况、集中趋势和数据分布。
(1)描述性统计回答的是一个最基本的问题:这批数据长什么样。它把样本量、缺失情况、平均水平、波动范围和类别构成理出来,是后面所有分析的地基——问卷、实验、回归都一样。
(2)它本身不下结论。均值不同不等于两组有差异,波动小不等于关系强,分布规律也不等于因果。它的用处是让你在选模型之前先看清数据:缺失多不多、有没有越界值、哪些列其实是分类变量、量表各维度大概什么水平。
(3)常见的指标有:有效样本量、缺失数与缺失率;均值、中位数、众数;标准差、四分位数与取值范围;分类变量的频数和百分比;必要时再看偏度、峰度或正态性。
(4)有一点要记住:均值没有脱离变量含义的好坏。满意度均值高多半是好事,投诉次数均值高却是问题。解释时一定结合题目含义、量表方向和编码。
(5)想回答"两组有没有差异""变量是否相关""A 能不能预测 B""量表信度和结构如何""谁导致谁",这些都不是描述性统计能给的,要用 t 检验、方差分析、相关、回归、信度、EFA/CFA/SEM、中介或调节。
1. 数据要长什么样
推荐"每行一条记录、每列一个变量":
| 编号 | 满意度 | 使用意愿 | 性别 | 年级 |
|---|---|---|---|---|
| 1 | 4 | 5 | 男 | 大二 |
| 2 | 3 | 4 | 女 | 大三 |
| 3 | 5 | 5 | 男 | 大二 |
准备时注意几点:列名清晰且唯一,第一行就是列名;一行对应一个受访者或实验单位;数值列存数字,别混进"无""不适用"这类文字;分类变量可以是文字或数字编码,但编码含义要留住;问卷数据最好带编码表(题目、维度、量表范围、反向题);多工作表的文件,要说明哪个 sheet 是实际数据。
数值变量看均值、标准差、分位数;分类变量看频数和百分比。性别、地区、专业这类即使存成 1、2、3,仍然是分类变量,不能当连续数值用。
2. 指标怎么算
设某个变量有 n 个有效数值,总记录数为 N。
(1)样本量、缺失和缺失率。有效样本量就是有效值的个数 n,缺失数 m=N-n,缺失率 r=m/N;注意表里 500 行,不代表每个变量都有 500 个有效值。
(2)均值。算术均值为
均值怕极端值:收入、金额、等待时间这类右偏变量,要同时看中位数和四分位数。
(3)中位数。把有效值从小到大排序后取中间:n 为奇数取中间那个,为偶数取中间两个的平均;它对极端值不敏感。
(4)标准差。样本标准差为
标准差越大,观测围绕均值的波动越大;只有在量纲和范围相近时,才适合横向比较不同变量的标准差。
(5)分位数和四分位距。第 p 分位数 Q_p 表示约有 p\times100\% 的有效观测不超过它,四分位距 IQR=Q_{75}-Q_{25} 反映中间约 50% 数据的跨度,比极差更抗极端值。
(6)频数和百分比。某个类别出现 f_j 次,则比例为 p_j=f_j/N;汇报时要说清分母是全部记录还是有效记录,两者结果不同。
(7)众数。出现次数最多的取值;分类变量可能有并列众数。
问卷数据要先把反向题反向计分,再算维度得分,别把正向题和没处理的反向题直接平均。
3. 结果怎么看
系统输出的工作表(analysis_tables.xlsx):描述性统计、缺失值报告、频数统计(有分类变量时);除卡方检验外,多数模型还会附带相关矩阵、相关显著性、显著性标记。
示例(来自系统结果包,示例数据),描述性统计表:
| 变量 | 样本量 | 缺失数 | 缺失率 | 均值 | 标准差 | 最小值 | 最大值 |
|---|---|---|---|---|---|---|---|
| Q1 | 200 | 0 | 0 | 3.41 | 0.8399 | 1 | 5 |
| Q2 | 200 | 0 | 0 | 3.43 | 0.7989 | 1 | 5 |
| Q3 | 200 | 0 | 0 | 3.47 | 0.776 | 1 | 5 |
看表的基本顺序:先扫样本量和缺失率,再确认最小值和最大值有没有越界;分布对称就看均值和标准差,明显偏态就重点看中位数和四分位数;最后按研究问题去比变量水平。频数表用来检查分类变量:类别全不全、有没有某一类样本特别少、缺失多不多、分组是不是严重失衡。
系统结果包中的实际图形(示例数据):
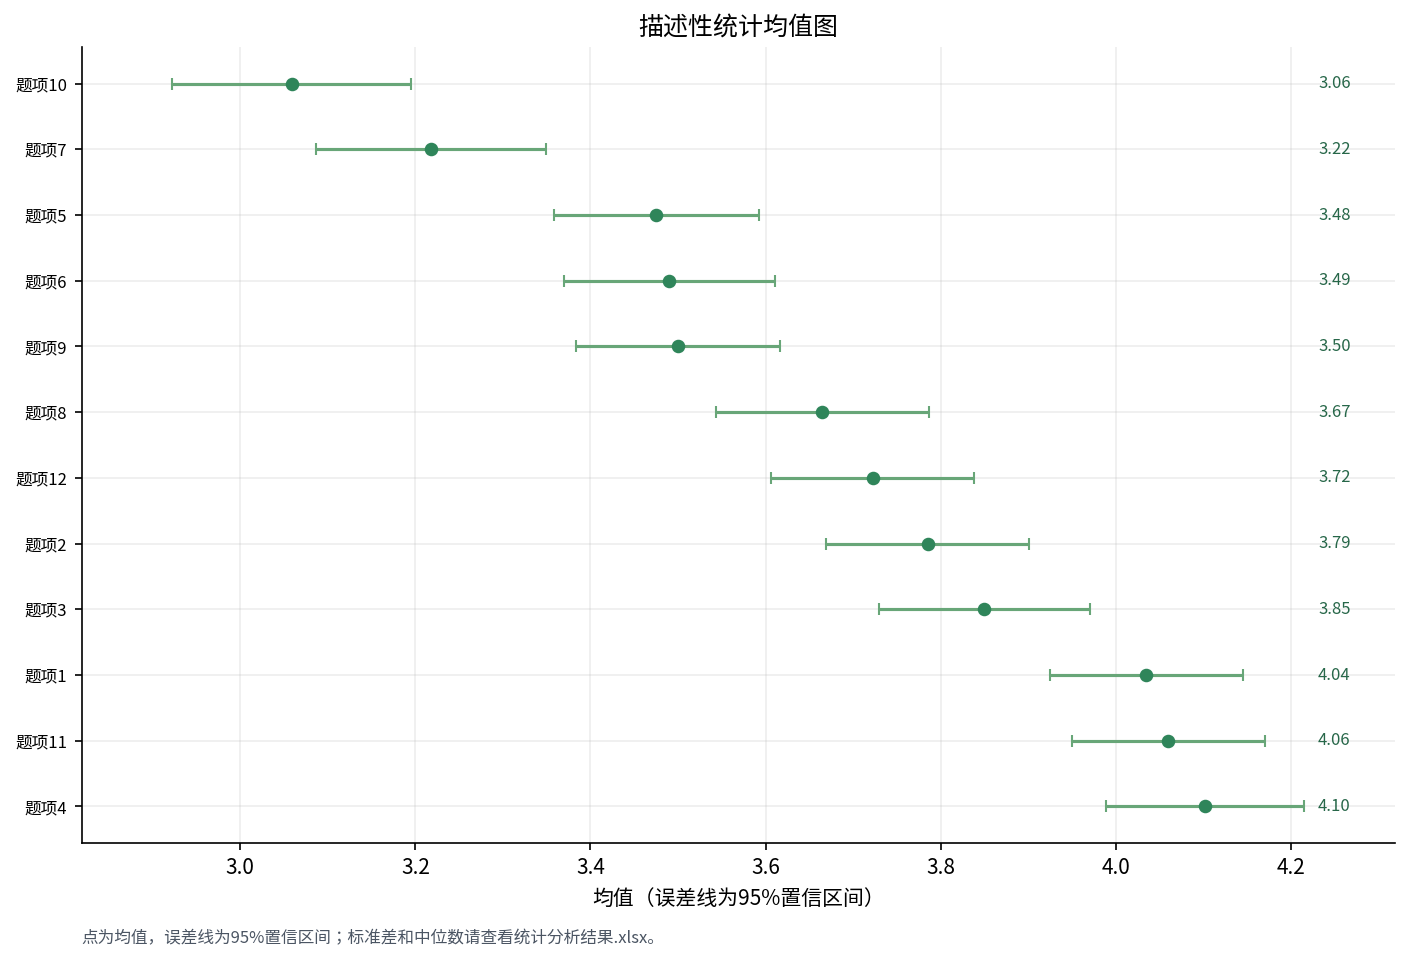
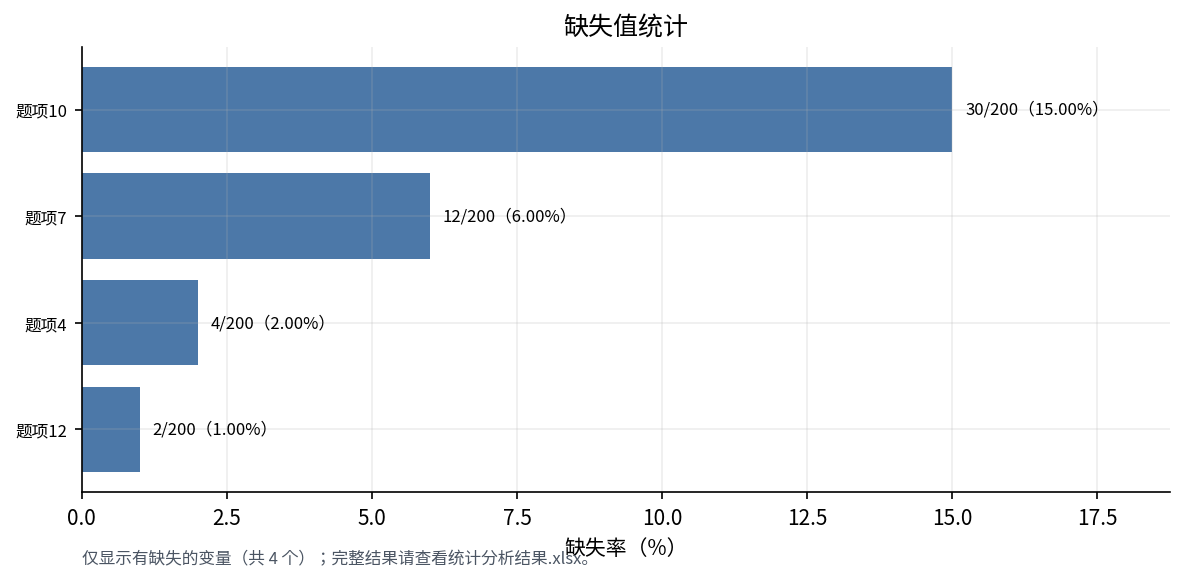
均值图能快速比较多个变量的平均水平,图中误差线为 95% 置信区间;看误差线之前要确认它代表标准差、标准误还是置信区间——三者不是一回事。图用来辅助,精确数值以表为准。
4. 有真实数据时怎么做
有真实数据时:明确问题和变量含义,准备数据并确认每行每列的含义,标出数值列、分类列、分组列和编号列,检查缺失、特殊编码和量表范围;如果是问卷,再确认反向题和维度归类。看完描述统计和频数,再决定用哪个后续模型。最后保存完整的表格和图形,别只留截图。
5. 常见问题
(1)均值和中位数差很多?多半是偏态分布、极端值或少量异常记录,去看四分位数和极值,必要时画箱线图或直方图。
(2)某一列没有均值?可能是分类文字、全部无法转成数值、有效值太少,或所有有效值都相同;改用频数表,或先确认变量类型。
(3)量表里出现 0、6、99、999?可能是越界录入,也可能是特殊缺失编码,按问卷规则确认,不能未经判断就当有效分数。
(4)描述性统计能证明假设吗?不能,它只描述样本,推断要靠与研究问题对应的检验。
6. 表述边界
可以写:本次分析纳入 320 条记录,满意度的有效样本量为 312,均值 3.84,标准差 0.71,中位数 4.00,第 25 和第 75 百分位数分别为 3.00 和 4.00,该变量有 8 条缺失,缺失率 2.50%。
不要写成"因为满意度均值较高,所以研究假设成立"。描述性统计适合放在论文的"样本与变量描述"部分,但替代不了差异检验、相关、回归或因果识别。