CFA 验证性因子分析
验证已有维度与题项映射的测量模型。
1. 方法概述
(1)验证性因子分析(Confirmatory Factor Analysis,CFA)用于检验一个事先提出的测量模型是否能够合理解释观测题项之间的协方差结构。与 EFA 不同,CFA 在分析前需要明确哪些题项测量哪些潜在因子,以及哪些载荷和误差相关被允许。
(2)CFA 主要回答:预先设定的潜变量与观测题项之间的测量关系,是否与数据相容?
(3)它可以用于验证量表的因子结构、比较竞争模型、检查聚合效度和区分效度。模型拟合良好不等于理论一定正确,也不代表所有结构路径具有因果含义。
2. 适用问题与不适用问题
适用情形:
- 已有理论或 EFA 结果提出明确的因子结构;
- 每个潜变量由多个观测题项测量;
- 有足够样本检验协方差结构;
- 题项类型、估计方法和数据分布相匹配。
需要谨慎或改用其他方法:
- 没有任何理论结构,只想从数据探索维度:先做 EFA;
- 每个潜变量只有一个题项且没有额外测量误差依据;
- 样本量很小、题项高度偏态或类别性质明显,却使用不匹配的连续正态估计;
- 反复依据修正指数加误差相关,直到拟合指标好看。
3. 数据结构和模型语法
每行是一名受访者,每列是一道观测题项。模型需要明确潜变量与题项的关系,例如:服务质量由 Q1、Q2、Q3 测量,满意度由 Q4、Q5、Q6 测量。
平台使用 semopy 语法:=~ 表示测量关系(潜变量由题项测量),~~ 表示潜变量之间的协方差。上面的模型写作:
服务质量 =~ Q1 + Q2 + Q3
满意度 =~ Q4 + Q5 + Q6
服务质量 ~~ 满意度
要点:
- 测量关系用
=~,每个潜变量至少要有一个题项; - 需要建模相关时用
~~连接两个潜变量; - 语法中的观测列名(Q1、Q2…)必须与数据列名完全一致;
- 潜变量名称(服务质量、满意度)是模型里的名字,不是数据中的列;
- 上传编码表后,系统可按维度自动生成测量模型语法(每个维度至少 3 个题项才会自动生成;不足时请手动填写),核对每个题项与维度后再提交。
4. 分析流程
5. 测量模型
第 j 个观测题项可以写为:
其中 \nu_j 是截距,\lambda_j 是因子载荷,\eta 是潜变量,\epsilon_j 是测量误差。多个潜变量时写成矩阵形式:
观测协方差矩阵由共同因子和误差共同决定:
CFA 的目标是用参数 \theta 使模型协方差矩阵 \boldsymbol{\Sigma}(\theta) 与样本协方差矩阵尽可能接近。
6. 识别、载荷和效度
潜变量的尺度通常通过固定一个载荷为 1 或固定因子方差来确定。若模型没有足够的约束,参数无法唯一估计,属于未识别模型。
标准化载荷越高,通常表示题项与潜变量的关系越强,但应结合标准误、置信区间、题项内容和残差判断。常用的聚合效度指标��括平均方差提取量:
其中 \lambda_j 是标准化载荷,\theta_j 是误差方差。复合信度可写为:
具体判断应结合理论和同类构念,而不是机械追求单一阈值。
7. 拟合指标
常见拟合信息包括卡方统计量、自由度、RMSEA、CFI、TLI、SRMR 和 AIC/BIC(用于比较模型时)。卡方检验对样本量敏感,不能只看 \chi^2/p 判断模型好坏。
一般需要同时报告:
- 模型自由度和卡方;
- RMSEA 及其置信区间;
- CFI、TLI;
- SRMR;
- 标准化载荷和因子相关;
- 模型比较时的差异检验和信息准则。
不同估计方法下拟合指标的计算和解释可能不同,应说明估计方法以及缺失值处理方法。
8. 修正指数和模型调整
修正指数表示释放某个约束后拟合可能改善的程度,但不是自动修改模型的指令。只有当误差相关或交叉载荷具有明确理论依据时,才应考虑调整;每次调整都应记录理由,并最好在独立样本中交叉验证。
9. 结果表格和图形的阅读方法
系统输出的工作表(analysis_tables.xlsx):CFA拟合指标、CFA拟合评价、CFA参数估计、CFA载荷评价、CFA效度分析、CFA区分效度、CFA分析提示、信度分析、信度题项分析、描述性统计、变量编码表、维度得分、相关矩阵、相关显著性、显著性标记、缺失值报告、频数统计。
示例(来自系统结果包,示例数据)。
CFA拟合指标表:
| 指标 | 数值 |
|---|---|
| chi2 | 61.298378 |
| DoF | 51 |
| CFI | 0.983609 |
| RMSEA | 0.031855 |
| NFI | 0.911711 |
CFA载荷评价表:
| 潜变量 | 观测变量 | 标准化载荷 | 误差方差 | 载荷评价 |
|---|---|---|---|---|
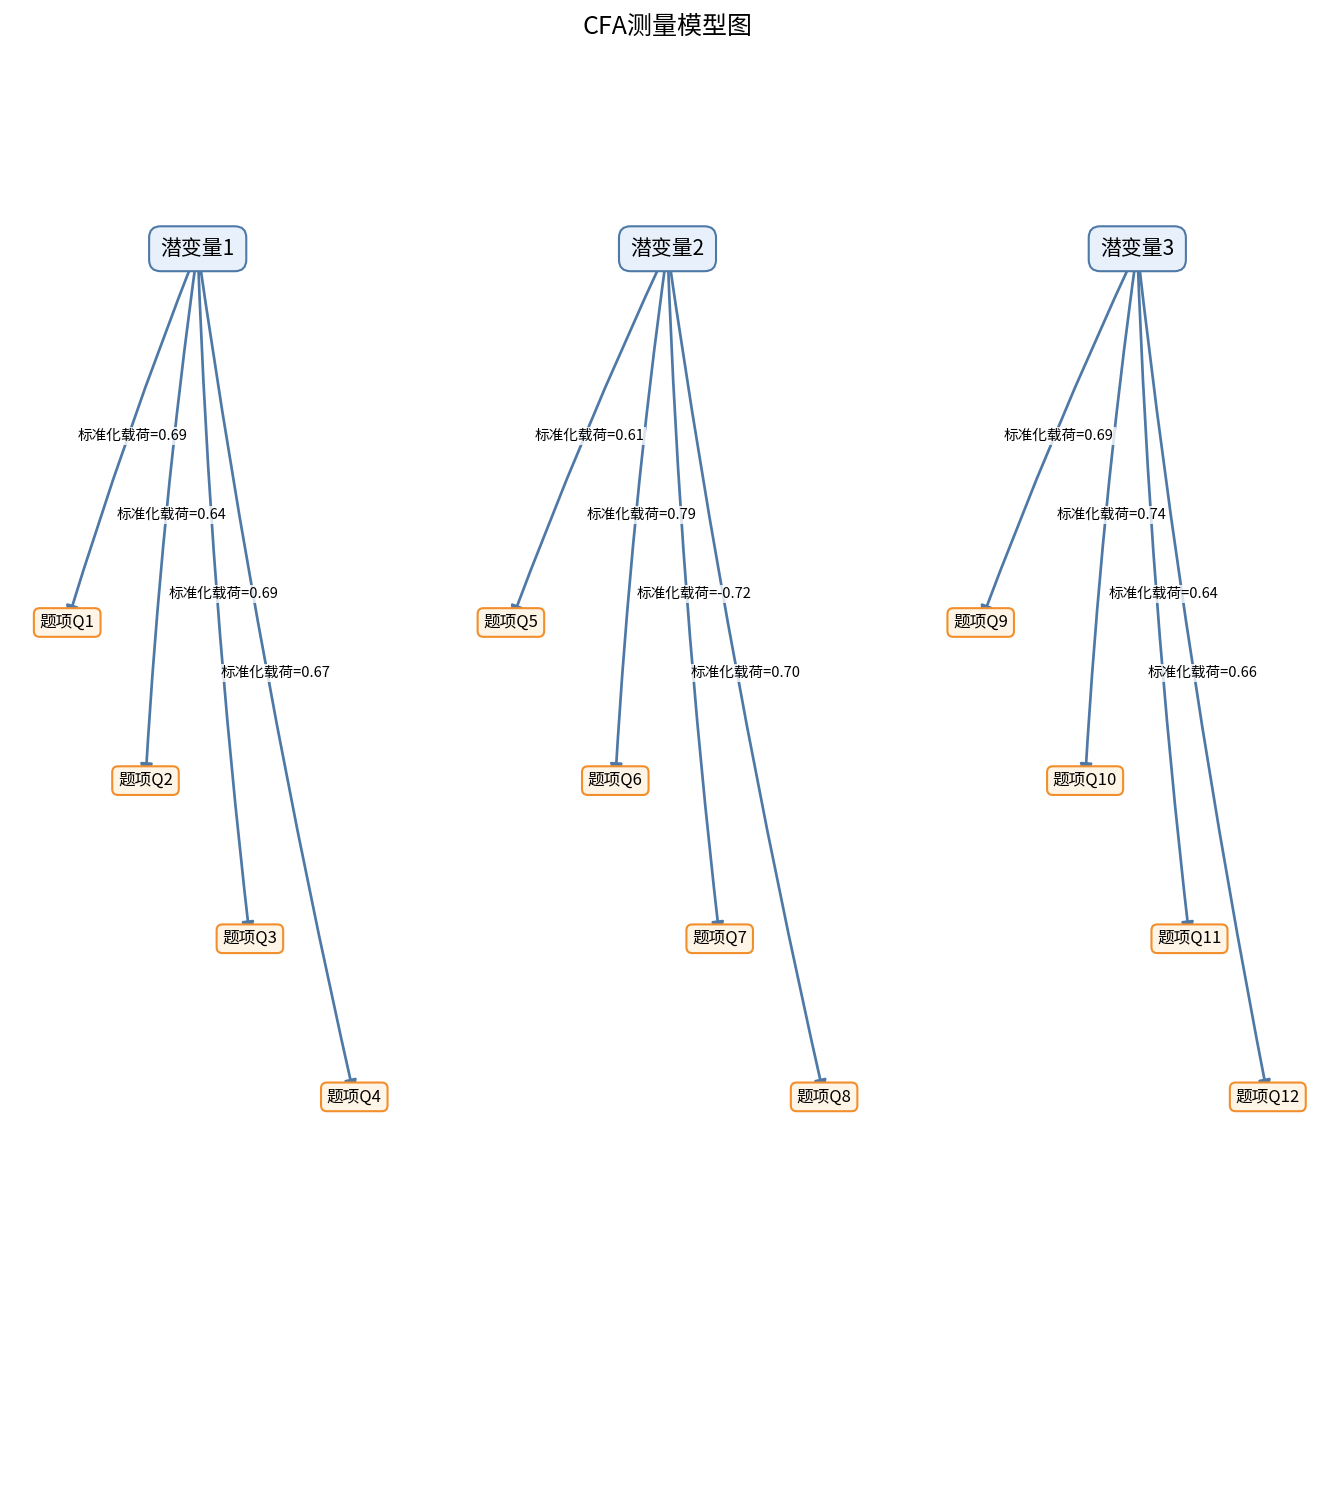
| F1 | Q1 | 0.689491 | 0.368221 | 载荷一般(0.50~0.70) |
| F1 | Q2 | 0.635434 | 0.378658 | 载荷一般(0.50~0.70) |
| F1 | Q3 | 0.694792 | 0.309892 | 载荷一般(0.50~0.70) |
建议输出模型语法或模型图、拟合指标表、标准化载荷表、误差方差、因子相关和效度指标。路径图适合展示测量关系,但精确数值应以表格为准。
10. 结果表述边界
可以表述为:“验证性因子分析显示,预设的两因子测量模型拟合指标为……,各题项在所属因子上的标准化载荷为……,因子间相关为……。”
不能把拟合良好写成“量表一定有效”或“模型证明了因果关系”。CFA 主要检验测量结构,不能单独证明潜变量之间的因果路径。
11. 常见问题
- 把 EFA 的探索结果直接当作 CFA 验证结果:最好使用独立样本验证。
- 只报告一个拟合指标:应报告多个互补指标和模型设定。
- 潜变量名称写进数据列选择:潜变量是模型中的抽象构念,不一定是数据列。
- 看到修正指数就加路径:没有理论依据的调整可能过拟合。