二元 Logistic 回归
预测二分类结果,例如是否购买。
1. 方法概述
(1)二元 Logistic 回归用于研究一个二分类结果发生的概率与一个或多个解释变量之间的关系。例如,是否购买、是否通过、是否患病、是否选择某方案等结果都可以编码为两个类别。
(2)与线性回归不同,Logistic 回归预测的是事件概率,系数通常通过优势比(odds ratio,OR)解释。它适合分类结果,但不应把 0 和 1 的平均值当作普通连续结果直接做线性回归。
2. 适用问题与不适用问题
适用问题
- 结果变量只有两个互斥类别;
- 事件类别和非事件类别定义清楚;
- 解释变量可以是连续变量、二分类变量或经过合理编码的多分类变量;
- 每一行是一个独立观测对象。
不适用或需要改用其他方法的情况
- 结果变量有三个或更多无序类别:考虑多项 Logistic 回归;
- 结果类别具有明确顺序:考虑有序 Logistic 回归;
- 结果是连续数值:考虑线性回归;
- 观测对象有重复测量或层级结构:考虑混合效应 Logistic 模型;
- 事件数量过少、完全分离或样本量不足:普通最大似然估计可能不稳定。
3. 数据结构和输入要求
示例数据:
| 编号 | 学习时间 | 是否参加培训 | 是否通过 |
|---|---|---|---|
| 1 | 12 | 是 | 是 |
| 2 | 7 | 否 | 否 |
| 3 | 15 | 是 | 是 |
结果变量必须严格只有两个有效类别,例如“是/否”或“通过/未通过”。如果使用 0/1 编码,应明确哪个类别是事件 Y=1。不能把 1、2、3 这样的多类别变量直接当作二分类结果。
多分类解释变量需要选择参考类别并建立虚拟变量。连续解释变量的单位应清楚,必要时应检查线性关系是否在 logit 尺度上成立。
4. 分析流程
5. Logistic 模型和 logit 变换
设 Y_i\in\{0,1\},事件 Y_i=1 的概率为 p_i=P(Y_i=1\mid X_i)。Logistic 模型为:
等价的 logit 形式为:
其中 p_i/(1-p_i) 是事件优势(odds),对数优势与解释变量呈线性关系。
6. 似然、系数和优势比
对于第 i 个观测,Bernoulli 似然贡献为:
全样本似然为:
回归系数通常通过最大化似然估计。对连续变量 X_j,增加一个单位时的优势比为:
解释规则为:
- OR>1:在其他变量相同的条件下,事件优势增加;
- OR<1:事件优势降低;
- OR=1:没有条件优势变化。
OR 不是概率差。一个固定的 OR 在不同基线概率下可能对应不同的概率变化,因此最好同时给出预测概率或边际效应。
7. 显著性检验和拟合评价
单个系数可以使用 Wald 统计量:
也可以使用似然比检验比较嵌套模型。整体模型的似然比统计量为:
其中 L_0 是仅含截距模型的似然,L_1 是当前模型的似然。
建议同时查看:对数似然与零模型对数似然、McFadden R^2、阈值 0.5 准确率、ROC 曲线与 AUC。单一指标不能完整评价分类模型。
8. 模型诊断和常见风险
- 事件稀少:系数和 OR 可能非常不稳定,应关注事件数与参数数量;
- 完全分离或准分离:某变量完全区分两类,最大似然估计可能发散;
- 多重共线性:会使系数标准误变大、方向不稳定;
- 连续变量的 logit 非线性:可考虑变换、分段项或样条;
- 类别不平衡:准确率可能具有误导性,应同时关注 AUC 等更稳健的指标;
- 过拟合:变量过多而样本或事件过少时,训练集表现不能代表新样本。
9. 结果表格和图形的阅读方法
系统输出的工作表(analysis_tables.xlsx):二元Logistic系数、二元Logistic模型摘要、描述性统计、相关矩阵、相关显著性、显著性标记、缺失值报告、频数统计。
示例(来自系统结果包,示例数据)。
二元Logistic系数表:
| 结果变量 | 预测变量 | 回归系数 | OR | SE | z | p |
|---|---|---|---|---|---|---|
| 是否购买 | 截距 | 0.303112 | 1.354066 | 0.166782 | 1.8174 | 0.069154 |
| 是否购买 | X1 | 0.984543 | 2.676587 | 0.192089 | 5.1254 | <0.001 |
二元Logistic模型摘要表:
| n | 阳性样本数 | 阴性样本数 | McFadden R² | 阈值0.5准确率 | AUC | 是否收敛 |
|---|---|---|---|---|---|---|
| 200 | 107 | 93 | 0.196539 | 0.715 | 0.787157 | 是 |
建议包括:
- 结果变量两类别(阳性 / 阴性)的样本数与比例(见模型摘要);
- 模型摘要:对数似然、零模型对数似然、McFadden R²、阈值 0.5 准确率、AUC、是否收敛;
- 系数表:回归系数、标准误、z(Wald)、p 值、OR 及 OR 的置信区间;
- Logistic ROC 曲线(AUC)与优势比图;
- 必要时的概率图。
系统结果包中的实际图形(示例数据):
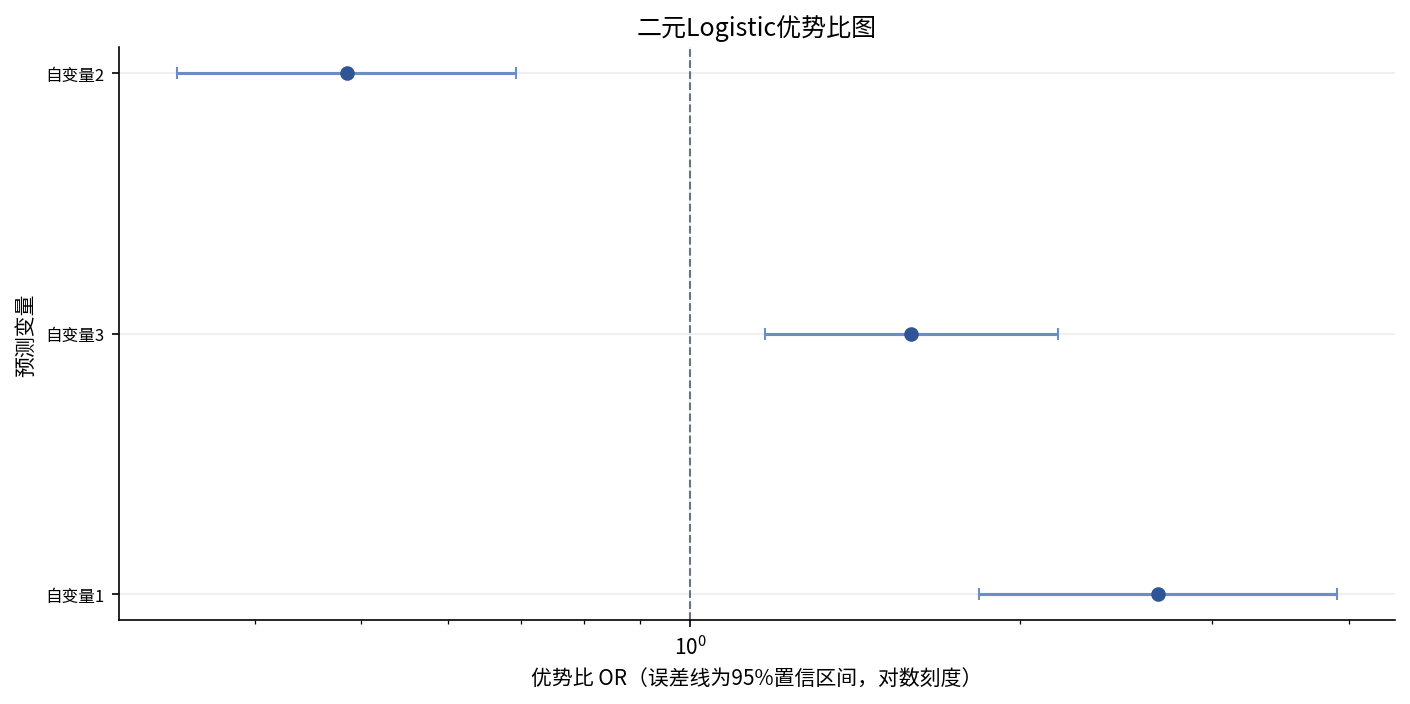
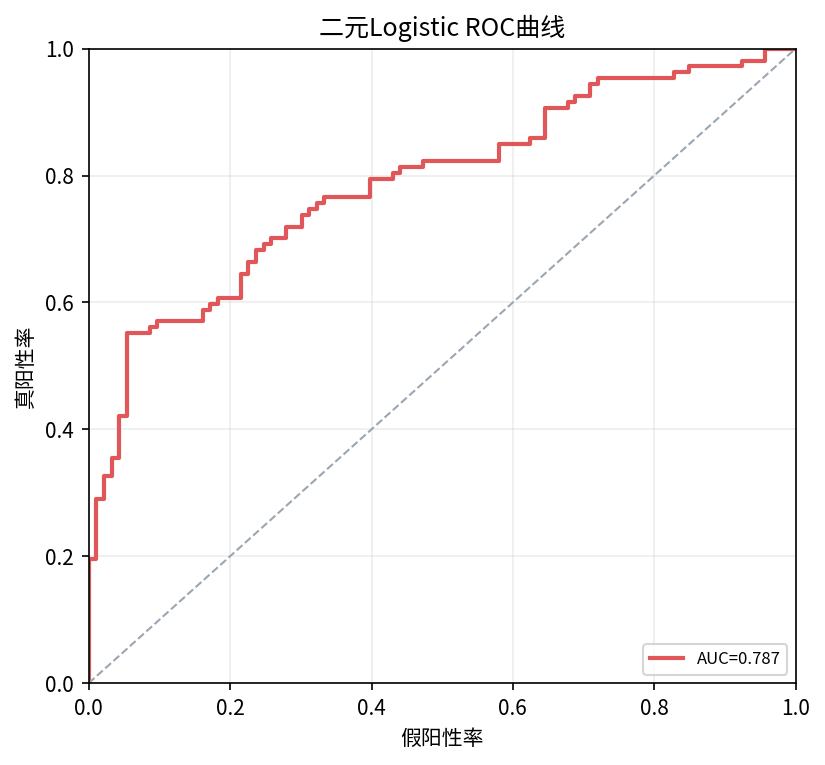
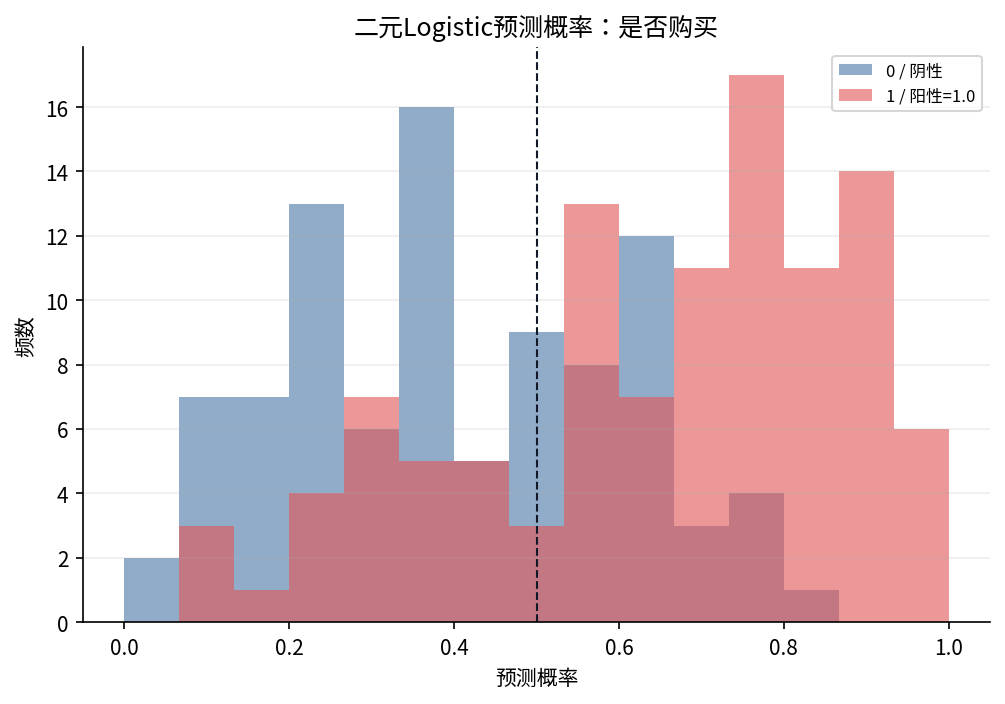
报告 OR 时必须注明比较方向、事件类别和连续变量的单位。对于分类解释变量,必须注明参考类别。
10. 结果表述边界
可以表述为:“在控制其他变量后,学习时间每增加 1 小时,通过的优势比为 OR=...,95% 置信区间为 [...],p=...。”
不能把 OR 直接写成“通过概率增加了 OR 倍”,也不能在观察性数据中自动写成“学习时间导致通过”。
11. 常见问题
- 把 0/1 结果当成普通连续结果做线性回归:应根据研究目的考虑 Logistic 回归。
- 忘记定义哪个类别是事件:改变事件编码会改变 OR 方向,必须在结果中说明。
- 只报告准确率:类别不平衡时准确率可能掩盖模型对少数类的识别失败。
- OR 显著就认为概率大幅提高:OR 和概率变化不是同一指标,应结合基线概率解释。